 GoSuda
Zvyšování odezvy pomocí client-side cache v Redisu

Co je Redis?
Předpokládám, že jen málokdo Redis nezná. Přesto, abych ho krátce připomněl prostřednictvím několika jeho vlastností, lze jej shrnout následovně.
- Operace se provádějí v jednom vlákně (single thread), a proto mají všechny operace atomicitu.
- Data jsou uložena a zpracovávána In-Memory, a proto jsou všechny operace rychlé.
- Redis může podle nastavení ukládat WAL, takže lze rychle zálohovat aktuální stav a obnovit jej.
- Podporuje různé typy jako Set, Hash, Bit, List a další, což zajišťuje vysokou produktivitu.
- Má velkou komunitu, takže lze sdílet a získávat různé zkušenosti, problémy a způsoby řešení.
- Je dlouhodobě vyvíjen a provozován, což zajišťuje důvěryhodnou stabilitu.
Nyní k věci
Představte si?
Co kdyby cache ve vaší službě splňovala následující dvě podmínky?
- Je nutné uživateli poskytovat často dotazovaná data v aktuálním stavu, avšak jejich aktualizace probíhá nepravidelně, a proto je třeba cache obnovovat velmi často.
- Data se neaktualizují, ale ke stejným cachovaným datům je nutné přistupovat a číst je velmi často.
Prvním případem může být zohlednění přehledu aktuální oblíbenosti v internetovém obchodě. Pokud je přehled aktuální oblíbenosti v internetovém obchodě uložen jako sorted set, je neefektivní, aby jej Redis při každém přístupu uživatele na hlavní stránku znovu načítal.
Druhým případem jsou data o směnných kurzech. I když jsou kurzy zveřejňovány zhruba v desetiminutových intervalech, jejich skutečné dotazy probíhají velmi často. Zejména u párů won-dolar, won-jen a won-juan dochází k velmi častému čtení z cache.
V takových případech by bylo efektivní, aby API server měl vlastní lokální cache a při změně dat znovu načetl Redis a provedl aktualizaci.
Jak tedy lze v architektuře databáze – Redis – API server tuto funkci implementovat??
Nedá se to řešit přes Redis PubSub?
Při použití cache bychom se měli přihlásit k odběru kanálu, ze kterého lze získat informaci o tom, zda došlo k aktualizaci!
- Je pak nutné vytvořit logiku, která při aktualizaci odešle zprávu.
- Dodatečné operace spojené s PubSub ovlivňují výkon.
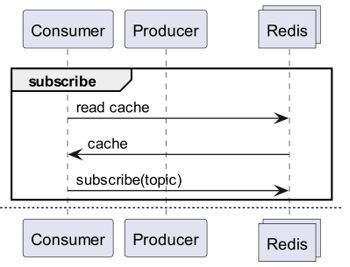
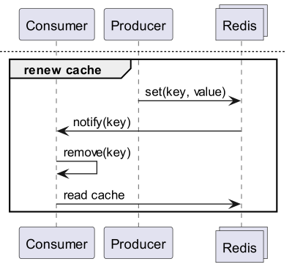
Co když Redis změny sám detekuje?
Co kdybychom pomocí Keyspace Notification dostávali oznámení o příkazech pro daný klíč?
- Je nutné předem uložit a sdílet klíče a příkazy používané k aktualizaci, což je pracné.
- Například u některých klíčů může být příkazem k aktualizaci jednoduchý Set, u jiných LPush, nebo RPush, SAdd a SRem, takže se situace stává složitou.
- To výrazně zvyšuje pravděpodobnost komunikačních chyb při vývoji a lidských chyb při programování.
Co kdybychom pomocí Keyevent Notification dostávali oznámení po jednotlivých příkazech?
- Je nutné přihlásit se k odběru všech příkazů používaných k aktualizaci. Přicházející klíče je třeba vhodně filtrovat.
- Například u klíčů přicházejících příkazem Del klient pravděpodobně nemá žádnou lokální cache.
- To může vést k zbytečnému plýtvání prostředky.
Proto potřebujeme Invalidation Message!
Co je Invalidation Message?
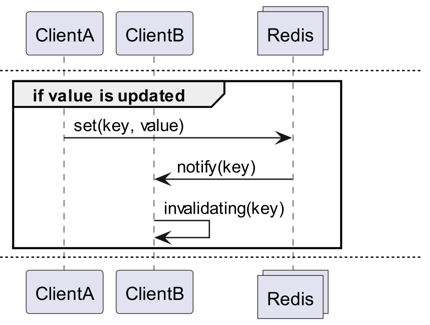
Invalidation Messages je koncept poskytovaný v rámci Server Assisted Client-Side Cache, který byl přidán v Redis 6.0. Invalidation Message je doručována následujícím postupem.
- Předpokládejme, že ClientB již jednou přečetl key.
- ClientA tento key nově nastaví.
- Redis změnu detekuje a vydá ClientB Invalidation Message, kterou ho informuje, aby cache vymazal.
- ClientB zprávu přijme a provede příslušné kroky.
Jak se to používá
Základní struktura fungování
Klient připojený k Redisu spustí CLIENT TRACKING ON REDIRECT <client-id>, čímž zajistí, že bude přijímat invalidation message. Klient, který má tyto zprávy přijímat, se pak přihlásí k odběru pomocí SUBSCRIBE __redis__:invalidate.
Výchozí tracking (default tracking)
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
Broadcasting tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
Implementace! Implementace! Implementace!
Redigo + Ristretto
Pouhé takto abstraktní vysvětlení je nejasné, jak to skutečně použít v kódu. Proto nejprve sestavíme jednoduchou verzi pomocí redigo a ristretto.
Nejprve nainstalujeme obě závislosti.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // number of keys to track frequency of (10M).
22		MaxCost:     1 << 30, // maximum cost of cache (1GB).
23		BufferItems: 64,      // number of keys per Get buffer.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Nejprve jednoduše vytvoříme RedisClient, který obsahuje ristretto a redigo.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
Kód je poněkud složitý.
- Pro tracking navazujeme ještě jedno další připojení. Učiněno proto, aby PubSub nerušil ostatní operace.
- Zjistíme ID přidaného připojení a v připojení, které čte data, nastavíme tracking tak, aby přesměrovával na toto připojení.
- Poté se přihlásíme k odběru invalidation message.
- Zpracování odběru je poněkud složité. Protože redigo neumí parsovat invalidation message, je nutné přijmout odpověď a zpracovat ji před parsováním.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
Metoda Get nejprve hledá v ristretto a pokud tam hodnota není, načte ji z Redisu, jak ukazuje následující kód.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
Kód pro testování je výše uvedený. Pokud jej vyzkoušíte, uvidíte, že se hodnota pokaždé aktualizuje při každé změně dat v Redisu.
Toto řešení je však příliš složité. Především je pro škálování na cluster nutné aktivovat tracking na všech masterech i replikách.
Rueidis
Pokud píšeme v jazyce Go, máme k dispozici nejmodernější a nejvyspělejší rueidis. Napíšeme kód, který používá server assisted client side cache v prostředí Redis clusteru pomocí rueidis.
Nejprve nainstalujeme závislost.
github.com/redis/rueidis
Poté napíšeme kód, který načítá data z Redisu.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
Pro použití client side cache v rueidis stačí jen zavolat DoCache. Poté se záznam přidá do lokální cache s dobou, po kterou má být v lokální cache uchován. Opakované volání DoCache pak načte data přímo z lokální cache. Samozřejmě zpracovává i invalidation message správně.
Proč ne redis-go?
redis-go bohužel neposkytuje oficiální API pro server assisted client side cache. Navíc při vytváření PubSub otevírá nové připojení a neexistuje API, které by umožnilo přímý přístup k tomuto připojení, takže nelze zjistit ani client ID. Proto jsme usoudili, že konfigurace pomocí redis-go je nemožná, a tuto variantu jsme vynechali.
To je pěkné
Prostřednictvím struktury client side cache
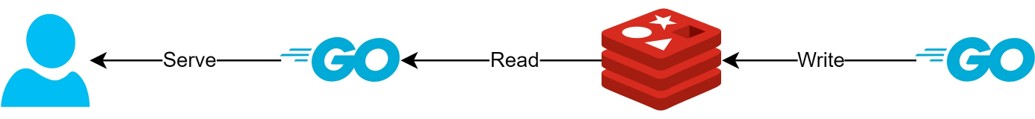
- Pokud lze data připravit předem, můžeme díky této struktuře minimalizovat dotazy a provoz na Redis a vždy poskytovat aktuální data.
- Tím lze vytvořit jakousi strukturu CQRS a výrazně zvýšit výkon čtení.
Jak moc se to zlepšilo?
Ve skutečnosti máme tuto strukturu právě v provozu, proto jsme u dvou API změřili přibližnou latenci. Omluvte prosím, že mohu uvést pouze velmi obecné údaje.
- První API
- Při prvním dotazu: průměrně 14,63 ms
- Při dalších dotazech: průměrně 2,82 ms
- Průměrný rozdíl: 10,98 ms
- Druhé API
- Při prvním dotazu: průměrně 14,05 ms
- Při dalších dotazech: průměrně 1,60 ms
- Průměrný rozdíl: 11,57 ms
Maximálně šlo o přibližně 82% dodatečné zlepšení latence!
Očekáváme, že došlo k následujícím zlepšením.
- Vynechání síťové komunikace mezi klientem a Redisem a úspora provozu
- Snížení počtu čtecích příkazů, které musí Redis sám provést
- To má také efekt zvýšení výkonu zápisu.
- Minimalizace parsování Redis protokolu
- Parsování Redis protokolu také není zcela bez nákladů. Jeho snížení je velká příležitost.
Každé řešení je ale kompromisem. Kvůli tomu jsme obětovali alespoň následující dvě věci.
- Nutnost implementace, provozu a údržby prvků pro správu client side cache
- Zvýšení využití CPU a paměti na straně klienta v důsledku tohoto řešení
Závěr
Osobně jsem považoval tento architektonický prvek za uspokojivý a latence i zátěž API serveru byla velmi nízká. Do budoucna bych rád, pokud to bude možné, navrhoval architekturu s touto strukturou.