 GoSuda
Verbesserung der Reaktionsfähigkeit durch clientseitiges Caching mit Redis

Was ist Redis?
Ich nehme an, dass die meisten Leser Redis bereits kennen. Dennoch möchte ich einige seiner Merkmale kurz erwähnen, die sich wie folgt zusammenfassen lassen.
- Die Operationen werden in einem einzelnen Thread ausgeführt, weshalb alle Operationen atomar sind.
- Die Daten werden In-Memory gespeichert und verarbeitet, weshalb alle Operationen schnell sind.
- Redis kann je nach Option ein WAL speichern, wodurch der aktuelle Zustand schnell gesichert und wiederhergestellt werden kann.
- Redis unterstützt verschiedene Datentypen wie Set, Hash, Bit und List, wodurch es eine hohe Produktivität bietet.
- Redis verfügt über eine große Community, wodurch man vielfältige Erfahrungen, Probleme und Lösungen teilen und erhalten kann.
- Redis wird seit langem entwickelt und betrieben, weshalb es eine vertrauenswürdige Stabilität besitzt.
Nun zum eigentlichen Thema
Stellen Sie sich vor?
Wie wäre es, wenn der Cache Ihres Dienstes die folgenden zwei Bedingungen erfüllt?
- Häufig abgefragte Daten müssen den Nutzern in aktuellem Zustand bereitgestellt werden, wobei die Aktualisierung unregelmäßig erfolgt und der Cache daher häufig aktualisiert werden muss
- Die Daten werden nicht aktualisiert, jedoch wird auf dieselben Cache-Daten häufig zugegriffen und abgefragt
Der erste Fall könnte beispielsweise die Echtzeit-Beliebtheitsrangliste eines Online-Shops sein. Wenn die Echtzeit-Beliebtheitsrangliste des Shops als Sorted Set gespeichert wird, ist es ineffizient, sie bei jedem Zugriff eines Nutzers auf die Hauptseite aus Redis auszulesen. Der zweite Fall betrifft Wechselkursdaten: Obwohl die Wechselkurse etwa im Zehn-Minuten-Takt veröffentlicht werden, finden die tatsächlichen Abfragen sehr häufig statt. Insbesondere für Won-Dollar, Won-Yen und Won-Yuan wird der Cache sehr häufig abgefragt. In diesen Fällen ist es ein effizientes Vorgehen, wenn der API-Server einen eigenen lokalen Cache vorhält und bei einer Datenänderung Redis erneut abfragt und aktualisiert.
Wie lässt sich dieses Verhalten nun in einer Struktur aus Datenbank, Redis und API-Server umsetzen??
Geht das nicht mit Redis PubSub?
Wenn man bei der Verwendung eines Caches einen Kanal abonniert, über den man Aktualisierungen erhalten kann!
- Dann muss eine Logik entwickelt werden, die bei einer Aktualisierung eine Nachricht sendet.
- Durch die zusätzlichen Vorgänge von PubSub wird die Leistung beeinträchtigt.
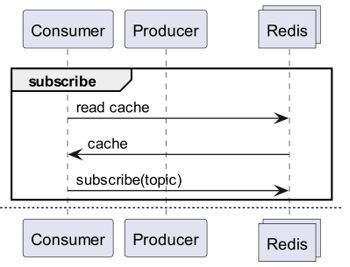
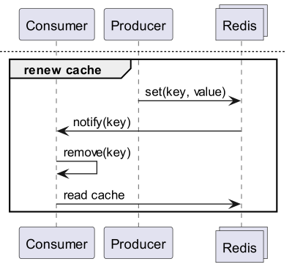
Was, wenn Redis Änderungen selbst erkennt?
Was, wenn man über Keyspace Notification Befehlsbenachrichtigungen für den jeweiligen Schlüssel erhält?
- Die Schlüssel und Befehle, die für Aktualisierungen verwendet werden, müssen im Voraus festgehalten und geteilt werden, was mühsam ist.
- Beispielsweise ist bei manchen Schlüsseln einfaches Set der aktualisierende Befehl, bei anderen LPush, RPush, SAdd oder SRem, was die Situation zunehmend komplex macht.
- Dadurch steigt die Wahrscheinlichkeit für Kommunikationsfehler während der Entwicklung und menschliche Fehler beim Programmieren erheblich.
Was, wenn man über Keyevent Notification Benachrichtigungen pro Befehl erhält?
- Es ist ein Abonnement für alle Befehle erforderlich, die Aktualisierungen durchführen. Die eingehenden Schlüssel müssen angemessen gefiltert werden.
- Beispielsweise besitzt der betreffende Client bei einigen der über DEL eingehenden Schlüssel mit hoher Wahrscheinlichkeit keinen lokalen Cache.
- Dies kann zu unnötiger Ressourcenverschwendung führen.
Deshalb benötigt man Invalidation Messages!
Was sind Invalidation Messages?
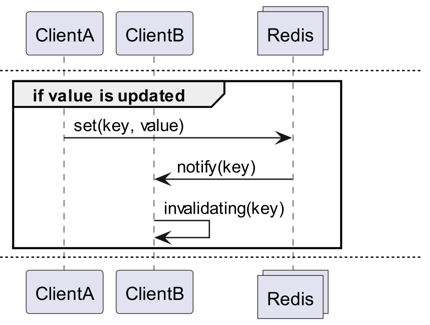
Invalidation Messages sind ein Konzept, das im Rahmen des Server Assisted Client-Side Cache bereitgestellt wird, der ab Redis 6.0 hinzugefügt wurde. Invalidation Messages werden über folgenden Ablauf übermittelt.
- Angenommen, ClientB hat den Key bereits einmal gelesen.
- ClientA setzt den betreffenden Key neu.
- Redis erkennt die Änderung und sendet an ClientB eine Invalidation Message, um ihn anzuweisen, den Cache zu leeren.
- ClientB empfängt die Nachricht und ergreift die geeigneten Maßnahmen.
Wie wird es verwendet?
Grundlegende Funktionsstruktur
Ein mit Redis verbundener Client führt CLIENT TRACKING ON REDIRECT <client-id> aus, damit er Invalidation Messages erhält. Der Client, der diese Nachrichten empfangen soll, abonniert anschließend mit SUBSCRIBE __redis__:invalidate die Invalidation Messages.
Default Tracking
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
Broadcasting Tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
Implementierung! Implementierung! Implementierung!
Redigo + Ristretto
Wenn man es nur so erklärt, ist unklar, wie man es im tatsächlichen Code verwenden soll. Deshalb werde ich zunächst eine einfache Konfiguration mit redigo und ristretto erstellen.
Zuerst installieren wir die beiden Abhängigkeiten.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // Anzahl der Schlüssel, deren Häufigkeit verfolgt wird (10 Mio.).
22		MaxCost:     1 << 30, // Maximale Kosten des Caches (1 GB).
23		BufferItems: 64,      // Anzahl der Schlüssel pro Get-Puffer.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Zunächst erstellen wir einfach einen RedisClient, der ristretto und redigo enthält.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
Der Code ist etwas komplex.
- Für das Tracking wird eine weitere Verbindung aufgebaut. Dies geschieht, um zu verhindern, dass PubSub andere Vorgänge stört.
- Die ID der zusätzlichen Verbindung wird abgefragt, und das Tracking der Verbindung, die Daten abfragt, wird auf diese Verbindung umgeleitet.
- Anschließend wird die Invalidation Message abonniert.
- Die Verarbeitung der Abonnements ist etwas komplex. Da redigo die Invalidation Messages nicht parst, muss die Antwort vor dem Parsen empfangen und verarbeitet werden.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
Die Methode Get fragt, wie folgt dargestellt, zunächst ristretto ab und ruft die Daten aus Redis ab, falls kein Eintrag vorhanden ist.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
Der Testcode sieht wie oben aus. Wenn Sie ihn einmal testen, werden Sie feststellen, dass der Wert jedes Mal neu aktualisiert wird, wenn die Daten in Redis geändert werden.
Dies ist jedoch zu komplex. Vor allem ist für die Skalierung auf einen Cluster zwingend erforderlich, das Tracking für alle Master bzw. Replikate zu aktivieren.
Rueidis
Solange man Go verwendet, steht mit rueidis eine der modernsten und am weitesten entwickelten Bibliotheken zur Verfügung. Ich werde nun Code schreiben, der den Server Assisted Client Side Cache in einer Redis-Cluster-Umgebung mit rueidis verwendet.
Zunächst installieren wir die Abhängigkeit.
github.com/redis/rueidis
Anschließend schreiben wir Code, der Daten aus Redis abfragt.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
Für die Nutzung des Client Side Cache in rueidis genügt es, lediglich DoCache aufzurufen. Dabei wird angegeben, wie lange die Daten im lokalen Cache gehalten werden sollen. Wird anschließend erneut DoCache aufgerufen, werden die Daten aus dem lokalen Cache abgerufen. Selbstverständlich werden auch Invalidation Messages korrekt verarbeitet.
Warum nicht redis-go?
redis-go unterstützt leider keinen Server Assisted Client Side Cache über seine offizielle API. Darüber hinaus gibt es beim Erstellen eines PubSub, bei dem eine neue Verbindung entsteht, keine API für direkten Zugriff auf diese Verbindung, weshalb auch die Client-ID nicht ermittelt werden kann. Daher haben wir entschieden, dass sich redis-go nicht sinnvoll umsetzen lässt, und es nicht weiter berücksichtigt.
Sehr elegant
Durch die Struktur des Client Side Cache
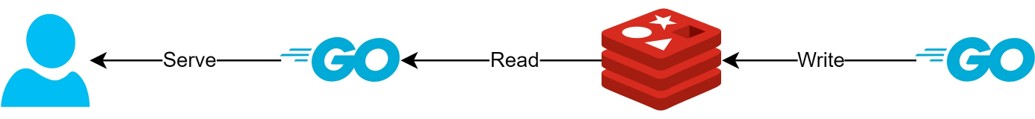
- Wenn sich die Daten im Voraus vorbereiten lassen, können Abfragen und Traffic zu Redis mit dieser Struktur minimiert und stets aktuelle Daten bereitgestellt werden.
- Dadurch lässt sich eine Art CQRS-Struktur aufbauen, die die Lese-Performance erheblich steigern kann.
Wie viel eleganter ist es geworden?
Da vor Ort gerade eine solche Struktur im Einsatz ist, haben wir die Latenzen zweier APIs grob gemessen. Bitte haben Sie Verständnis, dass ich mich nur sehr abstrakt ausdrücken kann.
- Erste API
- Bei der ersten Abfrage: durchschnittlich 14,63 ms
- Bei nachfolgenden Abfragen: durchschnittlich 2,82 ms
- Durchschnittliche Differenz: 10,98 ms
- Zweite API
- Bei der ersten Abfrage: durchschnittlich 14,05 ms
- Bei nachfolgenden Abfragen: durchschnittlich 1,60 ms
- Durchschnittliche Differenz: 11,57 ms
Im Maximum ergab sich eine zusätzliche Latenzverbesserung von etwa 82 %!
Ich gehe davon aus, dass folgende Verbesserungen erzielt wurden.
- Entfall der Netzwerkkommunikation zwischen Client und Redis sowie Einsparung von Traffic
- Verringerung der Anzahl der Lesebefehle, die Redis selbst ausführen muss
- Dies wirkt sich auch positiv auf die Schreibleistung aus.
- Minimierung des Parsens des Redis-Protokolls
- Das Parsen des Redis-Protokolls verursacht ebenfalls keinen vernachlässigbaren Aufwand. Diesen zu reduzieren, ist eine große Chance.
Doch jede Entscheidung ist ein Kompromiss. Dafür haben wir mindestens die folgenden zwei Aspekte in Kauf genommen.
- Implementierung, Betrieb und Wartung der Verwaltungskomponenten des Client Side Cache sind erforderlich
- Dadurch steigen die CPU- und Speichernutzung auf Seiten des Clients
Fazit
Persönlich war dies eine zufriedenstellende Architekturkomponente, und sowohl die Latenz als auch die Belastung des API-Servers waren sehr gering. Ich wünsche mir, dass wir künftig, wo immer möglich, Architekturen auf dieser Basis aufbauen.