 GoSuda
Randflake ID: Verteilte 64-Bit-Generierung eindeutiger IDs mit der Blockchiffre Sparx64

Man stelle sich eine Situation vor, in der eindeutige 64-Bit-Zufallszahlen erzeugt werden müssen und externe Parteien weder die nächste noch die vorherige Zahl vorhersagen können sollen.
Hierfür könnte man einen 8-Byte-Zufallswert erzeugen, prüfen, ob er bereits in der Datenbank existiert, und ihn anschließend speichern, sofern er eindeutig ist.
Dieses Verfahren weist jedoch mehrere Nachteile auf. Jede erzeugte Zahl muss in einer Datenbank gespeichert werden, um Eindeutigkeit sicherzustellen. Die Notwendigkeit mindestens eines Round Trips zur Datenbank verursacht Latenzprobleme, insbesondere in verteilten Umgebungen, in denen Skalierbarkeit entscheidend ist.
Um diese Probleme zu lösen, stellen wir Randflake ID vor: einen verteilten, gleichverteilten, nicht vorhersagbaren und eindeutigen Zufalls-ID-Generator.
Wie funktioniert Randflake ID?
Randflake ID ist von Snowflake ID inspiriert, dem weit verbreiteten, k-sortierbaren ID-Erzeugungsmechanismus, der von X (ehemals Twitter) entwickelt wurde.
Snowflake ID verwendet den aktuellen Zeitstempel, eine Node-ID und einen lokalen Zähler, um einen Identifikator zu erzeugen.
Wir haben diesen Ansatz für die Erzeugung eindeutiger Zufalls-IDs weiterentwickelt und ein neues Geheimschlüsselelement hinzugefügt.
Der zentrale Gedanke besteht darin, dem bestehenden Generator für eindeutige IDs eine Blockchiffre-Schicht hinzuzufügen, um die Vorhersage von Zusammenhängen zwischen Zahlen praktisch undurchführbar zu machen.
Eine Blockchiffre ist eine grundlegende kryptografische Funktion, die einen Klartextblock fester Länge in einen Chiffretextblock gleicher Länge transformiert. Diese Transformation wird durch einen kryptografischen Schlüssel gesteuert. Das charakteristische Merkmal einer Blockchiffre ist ihre Umkehrbarkeit: Sie muss eine eineindeutige (bijektive) Funktion sein, die sicherstellt, dass jede eindeutige Eingabe einer eindeutigen Ausgabe entspricht und umgekehrt. Diese Eigenschaft ist für die Entschlüsselung entscheidend, da sich der ursprüngliche Klartext bei Anwendung des korrekten Schlüssels aus dem Chiffretext wiederherstellen lässt.
Indem eine Blockchiffre als eineindeutige Funktion eingesetzt wird, lässt sich garantieren, dass jede eindeutige Eingabe eine entsprechende eindeutige Ausgabe innerhalb des definierten Wertebereichs erzeugt.
Aufbau und Gestaltungsüberlegungen
Aufbauend auf diesen grundlegenden Konzepten betrachten wir nun, wie Randflake ID diese Ideen in der Praxis umsetzt.
Die Struktur von Randflake ID umfasst einen 30-Bit-Unix-Zeitstempel mit Sekundengenauigkeit, eine 17-Bit-Node-Kennung, einen 17-Bit-lokalen Zähler sowie eine 64-Bit-Blockchiffre auf Basis des Algorithmus Sparx64.
Hierbei wurden folgende Gestaltungsentscheidungen getroffen:
Einige VM-Instanzen in der Google Cloud Platform können die Uhr auf 0,2 ms genau synchronisieren, eine solche Genauigkeit ist jedoch im öffentlichen Internet oder bei anderen Cloud-Anbietern nicht verfügbar.
Wir haben uns für eine Genauigkeit von einer Sekunde entschieden, da sich die Uhren zwischen Knoten nur im Bereich weniger Millisekunden wirksam synchronisieren lassen.
Eine 17-Bit-Node-Kennung ermöglicht 131072 einzelne Generatoren zur selben Zeit, die pro Prozess, pro Kern oder pro Thread zugewiesen werden können.
In Systemen mit hohem Durchsatz kann ein 17-Bit-lokaler Zähler unzureichend sein. Um den Durchsatz zu erreichen, können wir mehrere Generatoren mit jeweils unterschiedlicher Node-ID einsetzen, die in einem einzelnen Prozess oder Thread arbeiten.
Als 64-Bit-Blockchiffre haben wir Sparx64 gewählt, eine moderne, leichtgewichtige Blockchiffre auf ARX-Basis.
Randflake IDs bieten interne Rückverfolgbarkeit, da nur Personen, die im Besitz des geheimen Schlüssels sind, die ursprüngliche Node-ID und den Zeitstempel ermitteln können.
Der theoretische maximale Durchsatz beträgt 17.179.869.184 IDs/s, was für die meisten global skalierten Anwendungen ausreichend ist.
Pseudocode der Randflake-ID-Erzeugung
Zur weiteren Veranschaulichung des Erzeugungsprozesses von Randflake ID zeigt der folgende Python-Pseudocode eine vereinfachte Implementierung:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Konstanten
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Sonntag, 27. Oktober 2024 3:33:20 Uhr UTC
 7
 8# Bit-Zuweisung
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 Bit für den Zeitstempel (Lebensdauer von 34 Jahren)
10RANDFLAKE_NODE_BITS = 17  # 17 Bit für die Node-ID (max. 131072 Nodes)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 Bit für die Sequenz (max. 131072 Sequenzen)
12
13# Abgeleitete Konstanten
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Eine produktionsreife Implementierung von Randflake mit einem Mechanismus zur Vergabe von Node-ID-Leases ist auf GitHub verfügbar.
Weitere Überlegungen
In diesem Abschnitt erörtern wir einige zusätzliche Aspekte der Implementierung von Randflake ID.
Koordination der Node-ID
Wir schlagen eine leasebasierte Koordination der Node-IDs vor.
Bei diesem Ansatz weist ein zentraler Koordinationsdienst jedem Generator eine eindeutige Node-ID zu.
Diese Node-ID wird während der Lease-Laufzeit nicht neu vergeben, um die Eindeutigkeit sicherzustellen, wodurch die Notwendigkeit häufiger Kommunikation mit dem Koordinationsdienst verringert wird.
Der Generator, der das Lease hält, kann beim Koordinationsdienst eine Verlängerung des Leases beantragen, sofern die Verlängerungsbedingung erfüllt ist.
Die Verlängerungsbedingung bezeichnet eine Menge von Kriterien, die erfüllt sein müssen, damit das Lease verlängert wird, etwa dass der Generator noch aktiv ist und die Node-ID weiterhin benötigt.
Der Leaseinhaber ist der aktuelle Inhaber des Node-ID-Bereichs.
Das Lease gilt als aktiv und nicht abgelaufen, solange es sich innerhalb seines gültigen Zeitraums befindet.
Auf diese Weise lassen sich Round Trips auf einen pro Lease-Verlängerungszeitraum reduzieren, was die Latenz minimiert und die Effizienz verteilter Systeme verbessert.
Schutz vor fehlerhafter Uhr
Der Lease-Dienst muss bei der Vergabe eines Leases die Konsistenz der Zeitstempel prüfen. Der zugewiesene Beginn des Leases muss größer oder gleich dem Beginn des zuletzt vergebenen Leases sein.
Der Generator sollte die Anfrage ablehnen, wenn der aktuelle Zeitstempel kleiner als der Beginn des Leases oder größer als das Ende des Leases ist.
Dieses Verfahren ist wichtig, um die Eindeutigkeit der erzeugten IDs zu schützen, wenn die Uhr rückwärts springt. Springt beispielsweise eine Uhr rückwärts, könnte ein neues Lease mit einem früheren Beginn als bei einem zuvor vergebenen Lease zugewiesen werden, was potenziell zur Erzeugung doppelter IDs führt. Indem Anfragen mit Zeitstempeln innerhalb eines bestehenden Leasezeitraums abgelehnt werden, wird dieses Szenario verhindert und die Eindeutigkeit der IDs gewahrt.
Gleichverteilung der IDs
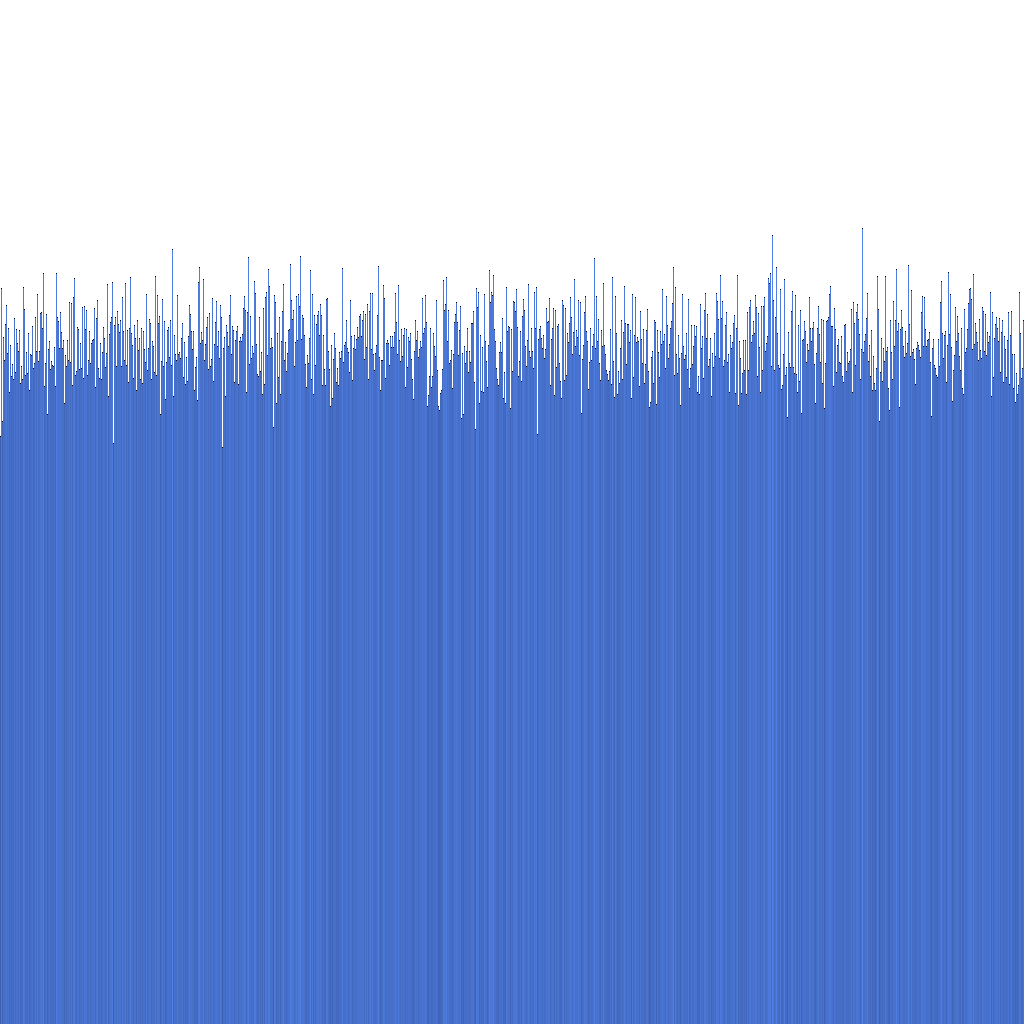
Anhand des obigen Histogramms zeigt sich, dass die Verteilung der erzeugten Randflake IDs sehr gleichmäßig ist. Dies legt nahe, dass die ID-Verteilung unmittelbar als Sharding-Schlüssel verwendet werden kann.
Fazit
In diesem Artikel haben wir Randflake vorgestellt, einen neuartigen Algorithmus zur ID-Erzeugung, der die Vorteile von Snowflake und Sparx64 vereint.
Wir hoffen, dass dieser Artikel Ihnen ein umfassendes Verständnis von Randflake und seiner Implementierung vermittelt hat.
Den vollständigen Quellcode von Randflake finden Sie auf GitHub.
Bei Fragen oder Anregungen zögern Sie bitte nicht, uns zu kontaktieren. Wir suchen außerdem Mitwirkende, die dabei helfen, Randflake zu verbessern und in anderen Programmiersprachen zu implementieren.
Wir planen, einen produktionsreifen Koordinationsdienst für Randflake und Snowflake zu veröffentlichen, der als Open Source auf GitHub bereitgestellt wird. Bleiben Sie gespannt auf weitere Neuigkeiten!