 GoSuda
Mejorar la capacidad de respuesta mediante una caché del lado del cliente con Redis

¿Qué es Redis?
Creo que son pocas las personas que no conocen Redis. Sin embargo, si lo mencionamos brevemente para repasar algunas de sus características, se pueden resumir de la siguiente manera.
- Las operaciones se ejecutan en un único hilo, por lo que todas las operaciones tienen atomicidad.
- Los datos se almacenan y operan In-Memory, por lo que todas las operaciones son rápidas.
- Redis puede guardar un WAL según la configuración, lo que permite respaldar y recuperar rápidamente el estado más reciente.
- Admite varios tipos de datos, como Set, Hash, Bit y List, lo que ofrece una gran productividad.
- Cuenta con una gran comunidad, por lo que es posible compartir y recibir diversas experiencias, incidencias y soluciones.
- Se ha desarrollado y mantenido durante mucho tiempo, por lo que ofrece una estabilidad en la que se puede confiar.
Ahora, al grano
¿Imaginen?
¿Qué pasaría si la caché de su servicio cumpliera las dos condiciones siguientes?
- Hay que proporcionar a los usuarios datos consultados con frecuencia en su estado más reciente, pero como las actualizaciones son irregulares, hay que refrescar la caché con frecuencia.
- Los datos no se actualizan, pero se accede y consulta repetidamente a la misma caché.
El primer caso puede ser el de la clasificación de popularidad en tiempo real de una tienda en línea. Si la clasificación de popularidad en tiempo real se guarda en un sorted set, leerla en Redis cada vez que un usuario accede a la página principal resulta ineficiente. El segundo caso son los datos de tipo de cambio: aunque los tipos de cambio se publican aproximadamente cada 10 minutos, las consultas reales se producen con muchísima frecuencia. Especialmente para won-dólar, won-yen y won-yuan, la caché se consulta con gran frecuencia. En estos casos, resulta más eficiente que el servidor de API mantenga una caché local separada y que, cuando los datos cambien, vuelva a consultar Redis para actualizarla.
Entonces, ¿cómo se puede implementar este comportamiento en una estructura de base de datos - Redis - servidor de API??
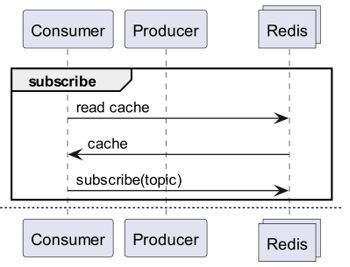
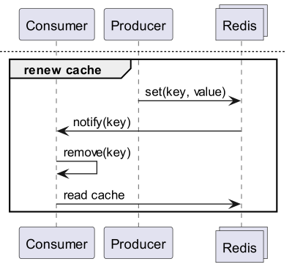
¿No se puede con Redis PubSub?
¡Al usar la caché, suscribámonos a un canal que permita recibir notificaciones de actualización!
- Entonces hay que crear una lógica que envíe un mensaje en cada actualización.
- Las operaciones adicionales de PubSub afectan al rendimiento.
¿Y si Redis detecta los cambios?
¿Y si usamos Keyspace Notification para recibir notificaciones de comandos sobre la clave correspondiente?
- Existe la molestia de tener que almacenar previamente y compartir las claves y los comandos usados para la actualización.
- Por ejemplo, para algunas claves el comando de actualización es un Set simple, mientras que para otras son LPush, RPush, SAdd o SRem, lo que lo vuelve complejo.
- Esto aumenta considerablemente la probabilidad de errores de comunicación durante el desarrollo y de errores humanos al programar.
¿Y si usamos Keyevent Notification para recibir notificaciones por comando?
- Es necesario suscribirse a todos los comandos que se usan para la actualización. Además, es necesario filtrar adecuadamente las claves que llegan.
- Por ejemplo, entre todas las claves que llegan mediante Del, es probable que este cliente no tenga caché local para algunas de ellas.
- Esto puede provocar un desperdicio innecesario de recursos.
¡Por eso se necesita Invalidation Message!
¿Qué es Invalidation Message?
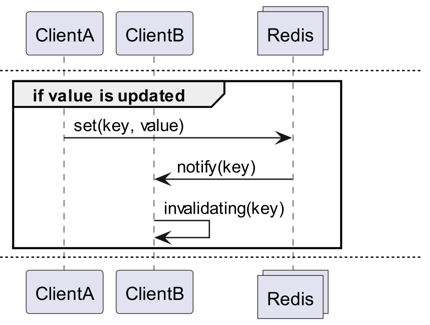
Invalidation Messages es un concepto que se ofrece como parte de Server Assisted Client-Side Cache, introducido en Redis 6.0. Los Invalidation Messages se transmiten con el siguiente flujo.
- Supongamos que ClientB ya leyó una vez la key.
- ClientA establece de nuevo esa key.
- Redis detecta el cambio y envía un Invalidation Message a ClientB para indicarle que elimine la caché.
- ClientB recibe el mensaje y toma las medidas adecuadas.
¿Cómo se usa?
Estructura básica de funcionamiento
Para que un cliente conectado a Redis reciba Invalidation Messages, ejecuta CLIENT TRACKING ON REDIRECT <client-id>. Después, el cliente que debe recibir los mensajes se suscribe a SUBSCRIBE __redis__:invalidate para recibirlos.
Default tracking
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
Broadcasting tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
¡Implementación! ¡Implementación! ¡Implementación!
Redigo + Ristretto
Si solo se explica de esa manera, resulta ambiguo cómo usarlo realmente en el código. Por eso, primero lo configuraremos de forma sencilla con redigo y ristretto.
Primero, instalamos las dos dependencias.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // número de claves para rastrear la frecuencia (10M).
22		MaxCost:     1 << 30, // costo máximo de la caché (1GB).
23		BufferItems: 64,      // número de claves por buffer de Get.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Primero creamos un RedisClient que incluye ristretto y redigo.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
El código es algo complejo.
- Para hacer Tracking se abre una conexión adicional. Esta medida tiene en cuenta que PubSub podría interferir con otras operaciones.
- Se obtiene el ID de la conexión adicional y se redirige el Tracking de la conexión que consulta los datos hacia esa conexión.
- Después, se suscribe a los invalidation messages.
- El código que procesa la suscripción es algo complejo. Como redigo no parsea los invalidation messages, hay que recibir la respuesta antes del parseo y procesarla.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
El método Get primero consulta ristretto de la siguiente manera y, si no encuentra el dato, lo obtiene de Redis.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
El código de prueba es el anterior. Si lo prueba, podrá comprobar que el valor se actualiza cada vez que los datos cambian en Redis.
Sin embargo, esto resulta demasiado complejo. Sobre todo, para escalar en un clúster es necesario habilitar inevitablemente el Tracking en todos los masters o réplicas.
Rueidis
Mientras se use Go, contamos con rueidis, la opción más moderna y avanzada. Escribiremos un código que utiliza server assisted client side cache en un entorno de clúster de Redis con rueidis.
Primero, instalamos la dependencia.
github.com/redis/rueidis
Y luego escribimos el código que consulta los datos en Redis.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
En rueidis, para usar client side cache basta con llamar a DoCache. Luego, al igual que en el caso de la caché local, como el tiempo de permanencia en la caché local se especifica al añadir el dato, al volver a llamar a DoCache los datos se obtienen de la caché local. Por supuesto, también procesa correctamente los invalidation messages.
¿Por qué no redis-go?
Lamentablemente, redis-go no admite server assisted client side cache mediante una API oficial. Además, al crear un PubSub se abre una nueva conexión sin una API que permita acceder directamente a ella, por lo que tampoco es posible conocer el client id. Por eso, consideramos que redis-go no permite esta configuración y lo descartamos.
Qué atractivo
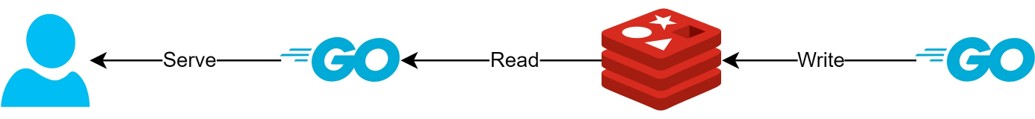
Mediante la estructura de client side cache
- Si los datos pueden prepararse de antemano, esta estructura permitirá minimizar las consultas y el tráfico hacia Redis, y ofrecer siempre datos actualizados.
- De este modo, se puede crear una especie de estructura CQRS que mejore notablemente el rendimiento de lectura.
¿Cuánto más atractivo se volvió?
En realidad, en el entorno actual se utiliza precisamente esta estructura, así que medimos la latencia aproximada de dos APIs. Les pedimos disculpas por presentar la información de forma muy abstracta.
- Primera API
- Primera consulta: promedio de 14.63 ms
- Consultas posteriores: promedio de 2.82 ms
- Diferencia promedio: 10.98 ms
- Segunda API
- Primera consulta: promedio de 14.05 ms
- Consultas posteriores: promedio de 1.60 ms
- Diferencia promedio: 11.57 ms
En el mejor de los casos, hubo una mejora adicional de la latencia de aproximadamente 82%.
Esperamos que se hayan producido las siguientes mejoras.
- Se omite la comunicación de red entre el cliente y Redis, lo que ahorra tráfico.
- Se reduce el número de comandos de lectura que Redis debe ejecutar.
- Esto también tiene el efecto de mejorar el rendimiento de escritura.
- Se minimiza el parseo del protocolo de Redis.
- Parsear el protocolo de Redis también tiene un coste no nulo. Poder reducirlo es una gran oportunidad.
Sin embargo, todo implica compensaciones. Para lograrlo, sacrificamos al menos los dos aspectos siguientes.
- Es necesario implementar, operar y mantener los elementos de gestión de la caché del lado del cliente.
- Esto aumenta el uso de CPU y memoria del cliente.
Conclusión
Personalmente, fue un componente de arquitectura satisfactorio, y el estrés sobre la latencia y el servidor de API también fue muy bajo. Espero que, siempre que sea posible, podamos seguir configurando la arquitectura con esta estructura.