 GoSuda
Randflake ID: Generación distribuida de identificadores únicos de 64 bits con el cifrado de bloques Sparx64

Considere una situación en la que necesitamos generar números aleatorios únicos de 64 bits, y las partes externas no deben poder predecir el número siguiente ni el anterior.
En este caso, podemos generar un valor aleatorio de 8 bytes, comprobar si ya existe en la base de datos y, a continuación, almacenarlo si es único.
Sin embargo, este método presenta varios inconvenientes. Debemos almacenar en una base de datos cada número generado para garantizar su unicidad. El requisito de al menos un viaje de ida y vuelta a la base de datos genera problemas de latencia, especialmente en un entorno distribuido donde la escalabilidad es fundamental.
Para resolver estos problemas, presentamos Randflake ID: un generador de identificadores aleatorios distribuido, uniforme, impredecible y único.
¿Cómo funciona Randflake ID?
Randflake ID se inspira en Snowflake ID, el mecanismo de generación de identificadores ordenables por tiempo (k-sorted) ampliamente utilizado, desarrollado por X (anteriormente Twitter).
Snowflake ID utiliza la marca de tiempo actual, un identificador de nodo y un contador local para generar un identificador.
Hemos ampliado este enfoque para la generación de identificadores únicos aleatorios y hemos añadido un nuevo elemento: una clave secreta.
La idea clave consiste en añadir una capa de cifrado por bloques al generador de identificadores únicos existente, para lograr que sea inviable predecir la relación entre los números.
Un cifrado por bloques es una función criptográfica fundamental que transforma un bloque de texto plano de longitud fija en un bloque de texto cifrado de la misma longitud. Esta transformación está gobernada por una clave criptográfica. La característica distintiva de un cifrado por bloques es su reversibilidad: debe ser una función biyectiva (uno a uno), lo que garantiza que cada entrada única se corresponda con una salida única, y viceversa. Esta propiedad es crucial para el descifrado, ya que permite recuperar el texto plano original a partir del texto cifrado cuando se aplica la clave correcta.
Al emplear un cifrado por bloques como función uno a uno, podemos garantizar que cada entrada única produzca una salida única correspondiente dentro del rango definido.
La estructura y las consideraciones de diseño
Partiendo de estos conceptos fundamentales, examinemos cómo Randflake ID implementa estas ideas en la práctica.
La estructura de Randflake ID incluye una marca de tiempo Unix de 30 bits con precisión de segundos, un identificador de nodo de 17 bits, un contador local de 17 bits y un cifrado por bloques de 64 bits basado en el algoritmo sparx64.
Estas son algunas decisiones de diseño:
Algunas instancias de máquinas virtuales en Google Cloud Platform pueden sincronizar el reloj con una precisión de 0,2 ms, pero ese nivel de precisión no está disponible en la internet pública ni en otros proveedores de nube.
Seleccionamos una precisión de segundos porque solo podemos sincronizar el reloj entre nodos de forma eficaz con resoluciones de unos pocos milisegundos.
Un identificador de nodo de 17 bits permite 131072 generadores individuales al mismo tiempo, que pueden asignarse por proceso, por núcleo o por hilo.
En sistemas de alto rendimiento, un contador local de 17 bits puede resultar insuficiente. Para igualar el rendimiento, podemos asignar múltiples generadores, cada uno con un identificador de nodo distinto, para que trabajen en un único proceso o hilo.
Adoptamos sparx64 como cifrado por bloques de 64 bits, un cifrado por bloques moderno y ligero basado en operaciones ARX.
Los identificadores Randflake ofrecen trazabilidad interna, revelando su identificador de nodo de origen y su marca de tiempo únicamente a quienes poseen la clave secreta.
El rendimiento máximo teórico es de 17.179.869.184 ID/s, lo cual es suficiente para la mayoría de aplicaciones de escala global.
Pseudocódigo de la generación de Randflake ID
Para ilustrar con más detalle el proceso de generación de Randflake ID, el siguiente pseudocódigo en Python ofrece una implementación simplificada:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Constantes
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Domingo, 27 de octubre de 2024, 3:33:20 AM UTC
 7
 8# Asignación de bits
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bits para la marca de tiempo (vida útil de 34 años)
10RANDFLAKE_NODE_BITS = 17  # 17 bits para el identificador de nodo (máximo 131072 nodos)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bits para la secuencia (máximo 131072 secuencias)
12
13# Constantes derivadas
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Una implementación lista para producción de Randflake, que incluye un mecanismo de arrendamiento (lease) de identificadores de nodo, está disponible en GitHub.
Otras consideraciones
En esta sección, analizaremos algunas consideraciones adicionales para la implementación de Randflake ID.
Coordinación de identificadores de nodo
Sugerimos una coordinación de identificadores de nodo basada en arrendamientos.
En este enfoque, un servicio central de coordinación asigna un identificador de nodo único a cada generador.
Este identificador de nodo no se reasigna durante el período de arrendamiento para garantizar su unicidad, lo que reduce la necesidad de una comunicación frecuente con el servicio de coordinación.
El generador que mantiene el arrendamiento puede solicitar la renovación del mismo al servicio de coordinación si se cumple la condición de renovación.
La condición de renovación se refiere a un conjunto de criterios que deben cumplirse para que el arrendamiento se renueve, como que el generador siga activo y necesite el identificador de nodo.
El titular del arrendamiento es el titular actual del rango de identificadores de nodo.
El arrendamiento se considera activo y no expirado si se encuentra dentro de su periodo de validez.
De este modo, podemos reducir los viajes de ida y vuelta a uno por cada periodo de renovación del arrendamiento, lo que minimiza la latencia y mejora la eficiencia en los sistemas distribuidos.
Mitigación frente a relojes defectuosos
El servicio de arrendamiento debe verificar la coherencia de las marcas de tiempo al asignar un arrendamiento. La hora de inicio asignada al arrendamiento debe ser mayor o igual que la hora de inicio del último arrendamiento.
El generador debe rechazar la solicitud si la marca de tiempo actual es menor que la hora de inicio del arrendamiento o mayor que la hora de fin del arrendamiento.
Este procedimiento es importante para proteger la unicidad de los identificadores generados cuando el reloj retrocede. Por ejemplo, si un reloj retrocede, podría asignarse un nuevo arrendamiento con una hora de inicio anterior a la de un arrendamiento asignado previamente, lo que podría provocar la generación de identificadores duplicados. Al rechazar las solicitudes con marcas de tiempo dentro de un periodo de arrendamiento existente, evitamos este escenario y mantenemos la unicidad de los identificadores.
Uniformidad de la distribución de identificadores
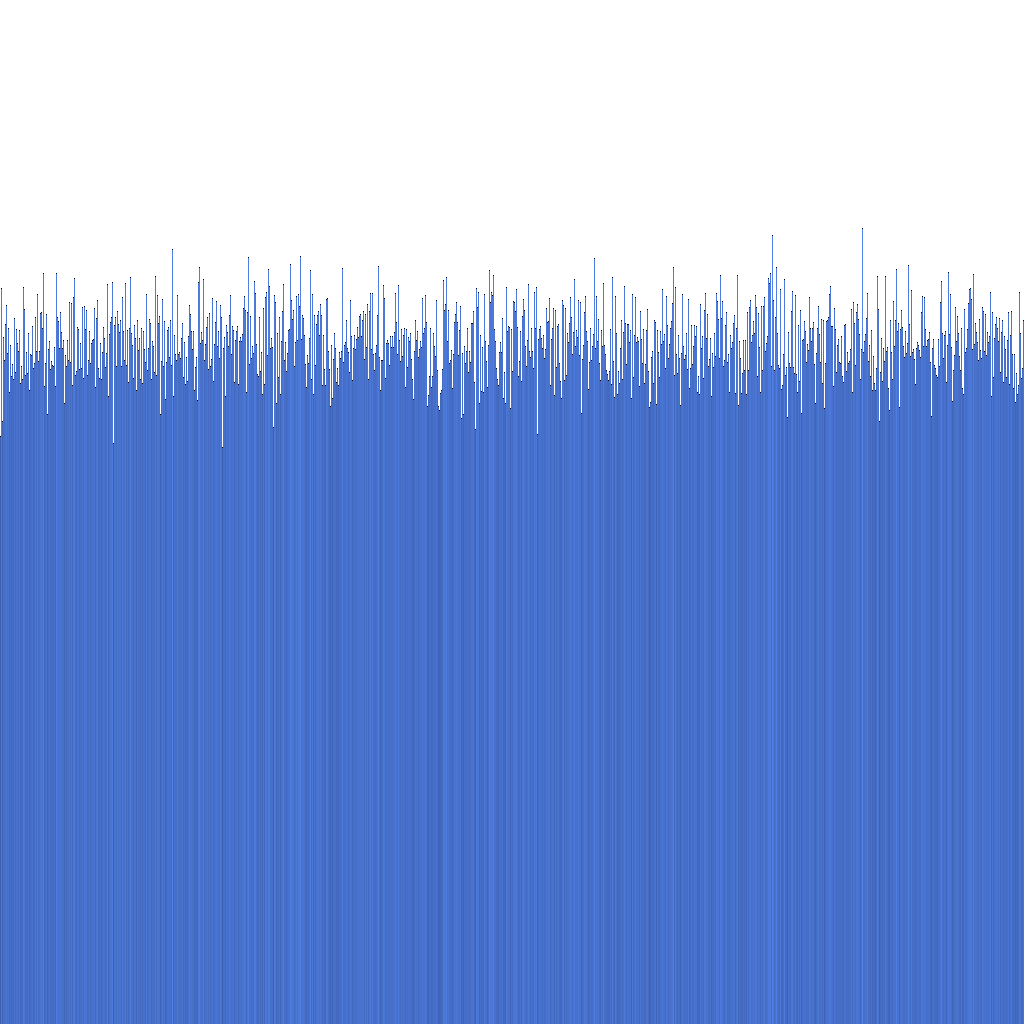
Según el histograma anterior, podemos observar que la distribución de los Randflake ID generados es muy uniforme. Esto sugiere que la distribución de los identificadores puede utilizarse directamente como clave de particionado (sharding).
Conclusión
En este artículo presentamos Randflake, un novedoso algoritmo de generación de identificadores que combina las ventajas de Snowflake y Sparx64.
Esperamos que este artículo le haya proporcionado una comprensión completa de Randflake y de su implementación.
Puede encontrar el código fuente completo de Randflake en GitHub.
Si tiene alguna pregunta o sugerencia, no dude en ponerse en contacto con nosotros. También buscamos colaboradores que ayuden a mejorar Randflake e implementarlo en otros lenguajes de programación.
Planeamos publicar un servicio de coordinación listo para producción para Randflake y Snowflake, que será de código abierto en GitHub. ¡Manténgase atento a las novedades!