 GoSuda
Migliorare la reattività con una cache lato client di Redis

Che cos'è Redis?
Credo che non ci siano molte persone che non conoscano Redis. Tuttavia, per riassumerne brevemente alcune caratteristiche prima di proseguire, si possono elencare come segue.
- Le operazioni vengono eseguite in un thread singolo, quindi tutte le operazioni godono di atomicità.
- I dati vengono memorizzati ed elaborati in memoria (In-Memory), quindi tutte le operazioni sono veloci.
- Redis può salvare il WAL in base alle opzioni configurate, consentendo di eseguire rapidamente il backup e il ripristino dello stato più recente.
- Supporta molteplici tipi di dati come Set, Hash, Bit e List, offrendo un'elevata produttività.
- Dispone di una community ampia, grazie alla quale è possibile condividere e ricevere esperienze, problemi e soluzioni diverse.
- È sviluppato e gestito da molto tempo, il che garantisce una stabilità affidabile.
Passiamo al tema principale
Immaginate?
Che cosa succederebbe se la cache del vostro servizio soddisfacesse le seguenti due condizioni?
- Quando è necessario fornire agli utenti dati frequentemente consultati nello stato più recente, ma gli aggiornamenti sono irregolari e la cache deve essere aggiornata di frequente
- Quando i dati della cache non vengono aggiornati, ma vi si accede e li si consulta di frequente
Il primo caso può riguardare la classifica di popolarità in tempo reale di un centro commerciale online. Se la classifica di popolarità in tempo reale viene memorizzata come sorted set, leggerla in Redis ogni volta che un utente accede alla pagina principale risulta inefficiente.
Il secondo caso riguarda i dati sui tassi di cambio: anche se i tassi vengono pubblicati indicativamente ogni 10 minuti, le consultazioni effettive avvengono con altissima frequenza. In particolare, la cache per won-dollaro, won-yen e won-yuan viene consultata molto spesso.
In questi casi, sarebbe più efficiente un funzionamento in cui il server API disponga di una propria cache locale separata e, quando i dati cambiano, interroghi nuovamente Redis per aggiornarla.
Come si può realizzare questo comportamento nella struttura database - Redis - server API?
Non si può fare con Redis PubSub?
Quando si utilizza una cache, iscriviamoci a un canale che consenta di ricevere notifiche sugli aggiornamenti!
- È quindi necessario creare una logica che invii un messaggio al momento dell'aggiornamento.
- Le operazioni aggiuntive introdotte da PubSub influiscono sulle prestazioni.
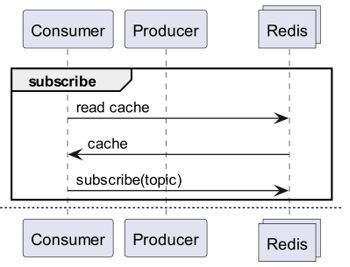
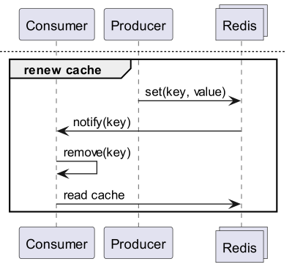
E se Redis rilevasse le modifiche?
E se ricevessimo notifiche sui comandi relativi a una specifica chiave tramite Keyspace Notification?
- Occorre predefinire e condividere le chiavi e i comandi utilizzati per l'aggiornamento, con un onere non trascurabile.
- Ad esempio, per alcune chiavi il comando di aggiornamento è un semplice Set, mentre per altre lo sono LPush, RPush, SAdd o SRem, e così via, con una complessità crescente.
- Ciò aumenta notevolmente la probabilità di errori di comunicazione durante lo sviluppo e di errori umani nella scrittura del codice.
E se ricevessimo notifiche per singolo comando tramite Keyevent Notification?
- È necessario sottoscriversi a tutti i comandi utilizzati per l'aggiornamento e occorre un filtraggio adeguato delle chiavi ricevute.
- Ad esempio, tra tutte le chiavi ricevute tramite Del, per alcune il client probabilmente non dispone di una cache locale.
- Ciò può portare a un inutile spreco di risorse.
Quindi ci serve il messaggio di Invalidation!
Che cos'è un Invalidation Message?
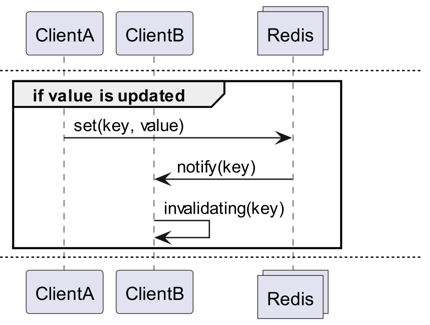
Gli Invalidation Message sono un concetto fornito come parte della Server Assisted Client-Side Cache, introdotta a partire da Redis 6.0. Gli Invalidation Message vengono trasmessi secondo il seguente flusso.
- Supponiamo che ClientB abbia già letto una volta la key.
- ClientA imposta nuovamente la key.
- Redis rileva la modifica e pubblica un Invalidation Message su ClientB, avvisandolo di eliminare la cache.
- ClientB riceve il messaggio e adotta le misure appropriate.
Come si utilizza?
Struttura di base del funzionamento
Un client connesso a Redis esegue CLIENT TRACKING ON REDIRECT <client-id> per ricevere gli Invalidation Message. Il client che deve ricevere i messaggi si iscrive poi a SUBSCRIBE __redis__:invalidate per ricevere gli Invalidation Message.
Default tracking
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
Broadcasting tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
Implementazione! Implementazione! Implementazione!
Redigo + Ristretto
Spiegarlo solo in questo modo rende poco chiaro come utilizzarlo effettivamente nel codice. Quindi, per semplicità, costruiamo prima un esempio con redigo e ristretto.
Per prima cosa installiamo le due dipendenze.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // numero di chiavi di cui tracciare la frequenza (10M).
22		MaxCost:     1 << 30, // costo massimo della cache (1GB).
23		BufferItems: 64,      // numero di chiavi per buffer di Get.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Innanzitutto creiamo un RedisClient semplice che contiene ristretto e redigo.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
Il codice è un po' complesso.
- Per eseguire il Tracking viene aperta un'ulteriore connessione. Questa scelta tiene conto del fatto che PubSub potrebbe interferire con le altre operazioni.
- Si ottiene l'ID della connessione aggiuntiva e si fa in modo che il Tracking della connessione che legge i dati venga reindirizzato verso di essa.
- Infine ci si iscrive agli Invalidation Message.
- La gestione della sottoscrizione è piuttosto complessa. Poiché redigo non effettua il parsing dei messaggi di invalidazione, occorre ricevere e gestire la risposta prima del parsing.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
Il metodo Get consulta prima ristretto come mostrato sopra e, se non trova il valore, lo recupera da Redis.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
Il codice di test è quello riportato sopra. Se lo eseguite, potrete verificare che il valore viene aggiornato ogni volta che i dati cambiano in Redis.
Tuttavia, questo approccio è troppo complesso. Soprattutto, per estendere la soluzione a un cluster è inevitabile attivare il Tracking su tutti i master o le repliche.
Rueidis
Se si utilizza Go, disponiamo di rueidis, la libreria più moderna ed evoluta. Scriviamo un codice che utilizza la server assisted client side cache in un ambiente cluster Redis tramite rueidis.
Per prima cosa installiamo la dipendenza.
github.com/redis/rueidis
Quindi scriviamo il codice che interroga i dati da Redis.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
Per usare la client side cache con rueidis basta chiamare DoCache. Si può poi stabilire per quanto tempo mantenere i dati nella cache locale; chiamando nuovamente DoCache i dati vengono letti direttamente dalla cache locale. Naturalmente, anche i messaggi di invalidazione vengono gestiti correttamente.
Perché non redis-go?
Purtroppo redis-go non supporta la server assisted client side cache tramite API ufficiali. Inoltre, quando crea una nuova connessione per PubSub, non offre un'API per accedervi direttamente, quindi non è possibile nemmeno conoscere il client ID. Per questo motivo abbiamo ritenuto che la configurazione con redis-go non fosse realizzabile e l'abbiamo esclusa.
Che figata
Attraverso la struttura della client side cache
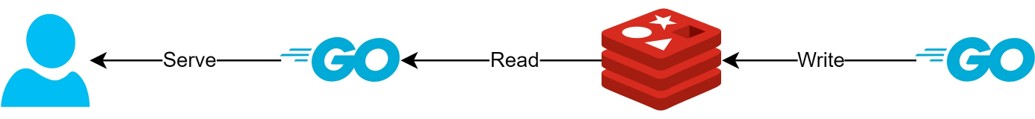
- Per i dati che possono essere preparati in anticipo, questa struttura consente di minimizzare le query e il traffico verso Redis, fornendo sempre dati aggiornati.
- In questo modo si può realizzare una sorta di struttura CQRS, aumentando notevolmente le prestazioni di lettura.
Quanto è migliorata?
In realtà, stiamo già utilizzando questa struttura sul campo, quindi abbiamo misurato la latenza di base per due API. Vi chiediamo gentilmente di scusarci per la natura molto astratta di questi dati.
- Prima API
- Alla prima consultazione: media 14,63 ms
- Consultazioni successive: media 2,82 ms
- Differenza media: 10,98 ms
- Seconda API
- Alla prima consultazione: media 14,05 ms
- Consultazioni successive: media 1,60 ms
- Differenza media: 11,57 ms
Si è registrato un miglioramento della latenza fino all'82% circa!
Ci aspettiamo che siano stati ottenuti i seguenti miglioramenti.
- Eliminazione della comunicazione di rete tra client e Redis e riduzione del traffico
- Riduzione del numero di comandi di lettura che Redis stesso deve eseguire
- Ciò ha anche l'effetto di migliorare le prestazioni di scrittura.
- Minimizzazione del parsing del protocollo Redis
- Anche il parsing del protocollo Redis non ha un costo nullo. Ridurlo è un'opportunità importante.
Tuttavia, ogni scelta comporta dei compromessi. Per questo abbiamo sacrificato almeno i seguenti due aspetti.
- Necessità di implementare, gestire e mantenere gli elementi di gestione della client side cache
- Conseguente aumento dell'utilizzo di CPU e memoria da parte del client
Conclusione
Personalmente ritengo che sia stato un componente architetturale soddisfacente, con una latenza molto contenuta e un carico molto ridotto sui server API. In futuro, se possibile, mi auguro di continuare a progettare le architetture secondo questa struttura.