 GoSuda
Randflake ID: generazione distribuita di identificatori univoci a 64 bit con il cifrario a blocchi Sparx64

Consideriamo una situazione in cui sia necessario generare numeri casuali unici a 64 bit, e in cui le parti esterne non debbano essere in grado di prevedere il numero successivo o precedente.
In questo caso, possiamo generare un valore casuale di 8 byte, verificare se esiste già nel database e, se è unico, memorizzarlo.
Tuttavia, questo metodo presenta diversi svantaggi. Dobbiamo memorizzare nel database ogni numero generato per garantire l'unicità. Il requisito di almeno un viaggio di andata e ritorno verso il database crea problemi di latenza, in particolare in un ambiente distribuito in cui la scalabilità è fondamentale.
Per risolvere questi problemi, presentiamo Randflake ID: un generatore di ID casuali distribuito, uniforme, imprevedibile e unico.
Come funziona Randflake ID?
Randflake ID è ispirato a Snowflake ID, il meccanismo di generazione di ID ordinabili (k-sorted) ampiamente utilizzato, sviluppato da X (in precedenza Twitter).
Snowflake ID utilizza il timestamp corrente, un ID del nodo e un contatore locale per generare un identificatore.
Abbiamo ampliato ulteriormente questo approccio per la generazione di ID unici casuali e vi abbiamo aggiunto un nuovo elemento: una chiave segreta.
L'idea chiave consiste nell'aggiungere uno strato di cifratura a blocchi al generatore di ID unici esistente, al fine di rendere computazionalmente infattibile la previsione della relazione tra i numeri.
Una cifratura a blocchi è una funzione crittografica fondamentale che trasforma un blocco di testo in chiaro di lunghezza fissa in un blocco di testo cifrato della stessa lunghezza. Tale trasformazione è governata da una chiave crittografica. La caratteristica distintiva di una cifratura a blocchi è la sua reversibilità: essa deve essere una funzione biunivoca (biettiva), che garantisce che ogni input unico corrisponda a un output unico, e viceversa. Questa proprietà è fondamentale per la decifratura, poiché consente di recuperare il testo in chiaro originale dal testo cifrato quando viene applicata la chiave corretta.
Impiegando una cifratura a blocchi come funzione biunivoca, possiamo garantire che ogni input unico produca un corrispondente output unico all'interno dell'intervallo definito.
La struttura e le considerazioni progettuali
Partendo da questi concetti fondamentali, esaminiamo come Randflake ID implementi queste idee nella pratica.
La struttura di Randflake ID comprende un timestamp Unix di 30 bit con precisione al secondo, un identificatore di nodo di 17 bit, un contatore locale di 17 bit e una cifratura a blocchi a 64 bit basata sull'algoritmo sparx64.
Di seguito alcune decisioni progettuali:
Alcune istanze VM in Google Cloud Platform possono sincronizzare l'orologio con una precisione di 0,2 ms, ma tale livello di accuratezza non è disponibile su internet pubblico o presso altri fornitori cloud.
Abbiamo scelto una precisione al secondo perché possiamo sincronizzare efficacemente l'orologio tra i nodi solo con una risoluzione di pochi millisecondi.
Un identificatore di nodo di 17 bit consente 131072 generatori individuali contemporaneamente, che possono essere assegnati per processo, per core o per thread.
Nei sistemi ad alto throughput, un contatore locale di 17 bit potrebbe risultare insufficiente. Per adeguarsi al throughput, possiamo assegnare più generatori, ciascuno con un ID di nodo distinto, a lavorare in un singolo processo o thread.
Abbiamo adottato sparx64 come cifratura a blocchi a 64 bit, una moderna cifratura a blocchi leggera basata su operazioni ARX.
Gli ID Randflake offrono tracciabilità interna, rivelando il loro ID di nodo di origine e il timestamp solo a chi possiede la chiave segreta.
Il throughput massimo teorico è di 17.179.869.184 ID/s, sufficiente per la maggior parte delle applicazioni su scala globale.
Pseudocodice della generazione di Randflake ID
Per illustrare ulteriormente il processo di generazione di Randflake ID, il seguente pseudocodice Python fornisce un'implementazione semplificata:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Costanti
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Domenica 27 ottobre 2024, ore 3:33:20 UTC
 7
 8# Allocazione dei bit
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bit per il timestamp (durata di 34 anni)
10RANDFLAKE_NODE_BITS = 17  # 17 bit per l'ID del nodo (massimo 131072 nodi)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bit per la sequenza (massimo 131072 sequenze)
12
13# Costanti derivate
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Un'implementazione pronta per la produzione di Randflake, che include un meccanismo di lease dell'ID del nodo, è disponibile su GitHub.
Altre considerazioni
In questa sezione discuteremo alcune considerazioni aggiuntive per l'implementazione di Randflake ID.
Coordinamento degli ID dei nodi
Suggeriamo un coordinamento degli ID dei nodi basato su lease.
In questo approccio, un servizio di coordinamento centrale assegna un ID di nodo unico a ciascun generatore.
Questo ID di nodo non viene riassegnato durante il periodo di lease, per garantire l'unicità, riducendo la necessità di comunicazioni frequenti con il servizio di coordinamento.
Il generatore titolare del lease può richiedere il rinnovo del lease al servizio di coordinamento se la condizione di rinnovo è soddisfatta.
La condizione di rinnovo fa riferimento a un insieme di criteri che devono essere soddisfatti affinché il lease possa essere rinnovato, ad esempio il fatto che il generatore sia ancora attivo e necessiti dell'ID di nodo.
Il titolare del lease è l'attuale detentore dell'intervallo di ID di nodo.
Il lease è considerato attivo e non scaduto se si trova nel suo periodo di validità.
In questo modo, possiamo ridurre i viaggi di andata e ritorno a uno per ogni periodo di rinnovo del lease, riducendo la latenza e migliorando l'efficienza nei sistemi distribuiti.
Mitigazione contro un orologio difettoso
Il servizio di lease deve verificare la coerenza dei timestamp al momento dell'assegnazione di un lease. L'orario di inizio del lease assegnato deve essere maggiore o uguale all'orario di inizio del lease precedente.
Il generatore deve rifiutare la richiesta se il timestamp corrente è inferiore all'orario di inizio del lease o superiore all'orario di fine del lease.
Questa procedura è importante per proteggere l'unicità degli ID generati quando l'orologio torna indietro. Ad esempio, se l'orologio torna indietro, potrebbe essere assegnato un nuovo lease con un orario di inizio precedente a quello di un lease già assegnato, con il rischio di generare ID duplicati. Rifiutando le richieste con timestamp che rientrano in un periodo di lease esistente, evitiamo questo scenario e manteniamo l'unicità degli ID.
Uniformità della distribuzione degli ID
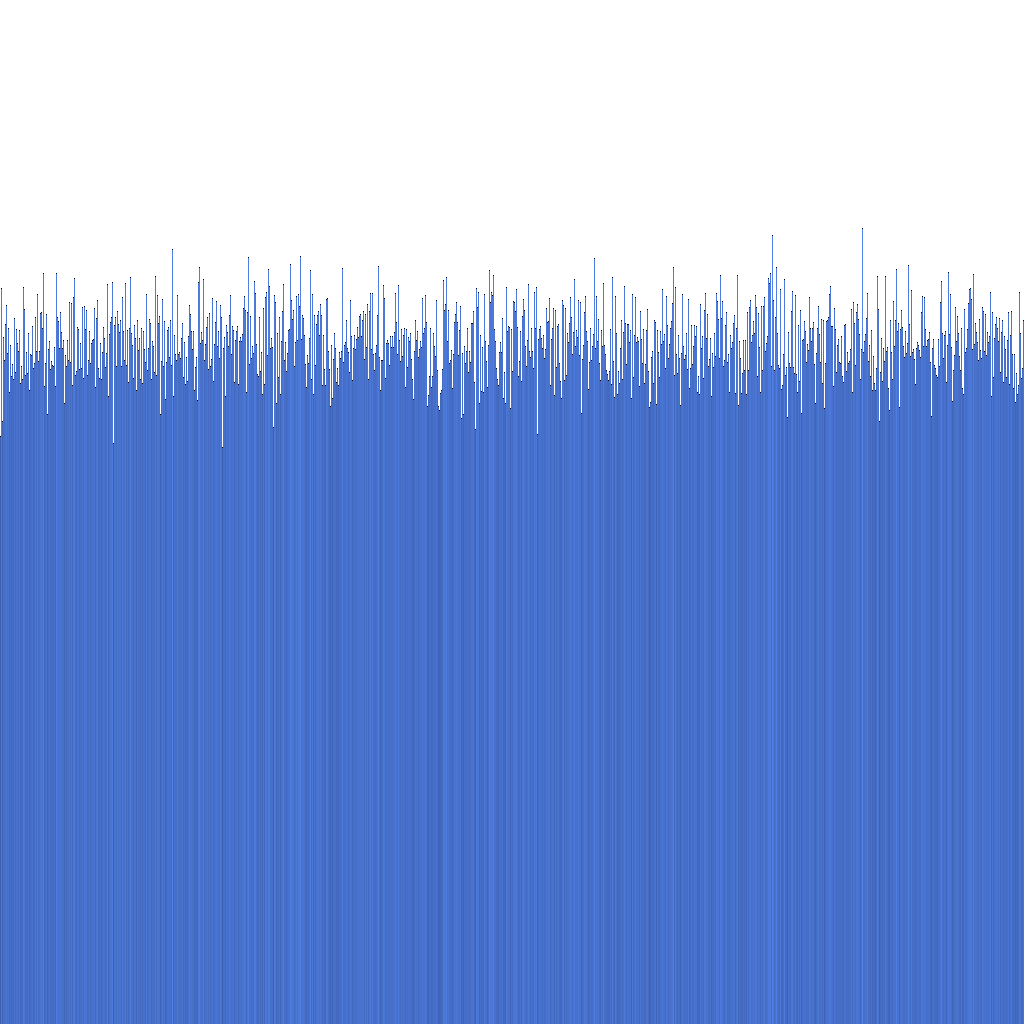
Sulla base dell'istogramma sopra riportato, possiamo osservare che la distribuzione degli ID Randflake generati è molto uniforme. Ciò suggerisce che la distribuzione degli ID può essere utilizzata direttamente come chiave di sharding.
Conclusione
In questo articolo abbiamo presentato Randflake, un nuovo algoritmo di generazione di ID che combina i vantaggi di Snowflake e Sparx64.
Speriamo che questo articolo vi abbia fornito una comprensione completa di Randflake e della sua implementazione.
È possibile trovare il codice sorgente completo di Randflake su GitHub.
In caso di domande o suggerimenti, non esitate a contattarci. Stiamo inoltre cercando collaboratori che contribuiscano a migliorare Randflake e a implementarlo in altri linguaggi di programmazione.
Stiamo pianificando di rilasciare un servizio di coordinamento pronto per la produzione per Randflake e Snowflake, che sarà open-source su GitHub. Restate sintonizzati per gli aggiornamenti!