 GoSuda
Cilium の物語:小さなコード変更がもたらした驚くべきネットワーク安定性の向上
はじめに
少し前に、元職場の同僚がCiliumプロジェクトに出したPRを眺めていました。
bpf:nat: Restore ORG NAT entry if it's not found
(テストコードを除くと)修正量そのものは if 文のブロックを一つ追加する程度で少ないです。しかし、この修正がもたらした影響は非常に大きく、単純なアイデア一つがシステムの安定性に大きく貢献しうるという事実が個人的に興味深く感じられたため、ネットワーク分野の専門知識がない方々にもこの事例を容易に理解していただけるよう、話を展開してみようと思います。
背景知識
スマートフォンに劣らず現代人にとって欠かせない必需品があるとすれば、おそらくWi-Fiルーターではないでしょうか。Wi-Fiルーターは、Wi-Fiという通信規格を介して機器と通信を行い、自身が持つグローバルIPアドレスを複数の機器で使用できるよう共有する役割を果たします。ここで生じる技術的な特異点は、どのように「共有」するのか?という点です。
ここで用いられる技術がまさにNetwork Address Translation(NAT)です。NATは、TCPあるいはUDP通信がIPアドレスとポート情報の組み合わせによって成り立つという点に着目し、プライベートIP:Port で行われる内部通信を、現在使用されていない グローバルIP:Port にマッピングすることで、外部との通信を可能にする技術です。
NAT
NAT装置は、内部の機器が外部インターネットに接続しようとするとき、当該機器のプライベートIPアドレスとポート番号の組み合わせを、自身のグローバルIPアドレスと未使用の任意のポート番号へと変換します。この変換情報は、NAT装置内部のNATテーブルと呼ばれる場所に記録されます。
例えば、家庭内のスマートフォン(プライベートIP: a.a.a.a、ポート: 50000)がWebサーバー(グローバルIP: c.c.c.c、ポート: 80)に接続しようとする場合を想定してみましょう。
1スマートフォン (a.a.a.a:50000) ==> ルーター (b.b.b.b) ==> Webサーバー (c.c.c.c:80)
ルーターはスマートフォンからの要求を受け取ると、次のようなTCPパケットを確認することになります。
1# ルーターが受信したTCPパケット、スマートフォン => ルーター
2| src ip  | src port | dst ip  | dst port |
3-------------------------------------------
4| a.a.a.a | 50000    | c.c.c.c | 80       |
このパケットをそのままWebサーバー(c.c.c.c)へ送信してしまうと、プライベートIPアドレスを持つスマートフォン(a.a.a.a)へ応答が戻ってこないため、ルーターはまず現在の通信に関与していない任意のポート(例:60000)を探し出し、内部のNATテーブルに記録しておきます。
1# ルーター内部のNATテーブル
2| local ip  | local port | global ip  | global port |
3-----------------------------------------------------
4| a.a.a.a   | 50000      | b.b.b.b    | 60000       |
ルーターはNATテーブルに新しいエントリを記録した後、スマートフォンから受け取ったTCPパケットの送信元IPアドレスとポート番号を、自身のグローバルIPアドレス(b.b.b.b)と新たに割り当てたポート番号(60000)に変更して、Webサーバーへ送信します。
1# ルーターが送信したTCPパケット、ルーター => Webサーバー
2# SNAT 実行
3| src ip  | src port | dst ip  | dst port |
4-------------------------------------------
5| b.b.b.b | 60000    | c.c.c.c | 80       |
これでWebサーバー(c.c.c.c)は、ルーター(b.b.b.b)の60000番ポートから届いた要求として認識し、応答パケットを次のようにルーターへ送信します。
1# ルーターが受信したTCPパケット、Webサーバー => ルーター
2| src ip  | src port | dst ip  | dst port |
3-------------------------------------------
4| c.c.c.c | 80       | b.b.b.b | 60000    |
ルーターはこの応答パケットを受け取ると、NATテーブルで宛先IPアドレス(b.b.b.b)とポート番号(60000)に対応する元のプライベートIPアドレス(a.a.a.a)とポート番号(50000)を探し出し、パケットの宛先をスマートフォンに変更します。
1# ルーターが送信したTCPパケット、ルーター => スマートフォン
2# DNAT 実行
3| src ip  | src port | dst ip  | dst port |
4-------------------------------------------
5| c.c.c.c | 80       | a.a.a.a | 50000    |
この過程を通じて、スマートフォンはあたかも自分自身がグローバルIPアドレスを持ってWebサーバーと通信しているかのように感じられるようになります。NATのおかげで、一つのグローバルIPアドレスを複数の内部機器が同時にインターネットで利用できるようになるのです。
Kubernetes
Kubernetesは、近年登場した技術の中でも最も精巧かつ複雑なネットワーク構造を持っています。そしてもちろん、前述のNATも様々な場面で活用されています。代表的な事例は次の二つです。
Pod内部からクラスタ外部と通信する場合
Kubernetesクラスタ内部のPodには、一般的にクラスタネットワーク内でのみ通信可能なプライベートIPアドレスが割り当てられます。したがって、Podが外部インターネットと通信するためには、クラスタ外部へ出ていくトラフィックに対してNATが必要になります。このときNATは、主に当該Podが実行されているKubernetesノード(クラスタの各サーバー)で行われます。Podが外部に向けてパケットを送信すると、そのパケットはまずPodが属するノードへ転送されます。ノードは、このパケットの送信元IPアドレス(Podのプライベートip)を自身のグローバルIPアドレスに置き換え、送信元ポートも適切に変更して外部へ転送します。この過程は、先ほどWi-Fiルーターで説明したNATの過程と類似しています。
例えば、Kubernetesクラスタ内のPod(10.0.1.10、ポート: 40000)が外部のAPIサーバー(203.0.113.45、ポート: 443)に接続すると仮定すると、Kubernetesノードは次のようなパケットをPodから受け取ることになり
1# ノードが受信したTCPパケット、Pod => ノード
2| src ip    | src port | dst ip        | dst port |
3---------------------------------------------------
4| 10.0.1.10 | 40000    | 203.0.113.45  | 443      |
ノードは次のような内容を記録した後
1# ノード内部のNATテーブル(例示)
2| local ip    | local port | global ip     | global port |
3---------------------------------------------------------
4| 10.0.1.10   | 40000      | 192.168.1.5   | 50000       |
次のようにSNATを実行してから、外部へパケットを送信することになります。
1# ノードが送信したTCPパケット、ノード => APIサーバー
2# SNAT 実行
3| src ip      | src port | dst ip        | dst port |
4-----------------------------------------------------
5| 192.168.1.5 | 50000    | 203.0.113.45  | 443      |
その後の過程は、先ほどのスマートフォンとルーターの事例と同じ過程をたどります。
クラスタ外部からNodePortを通じてPodと通信する場合
Kubernetesでサービスを外部に公開する方法の一つは、NodePortサービスを利用することです。NodePortサービスは、クラスタ内のすべてのノードの特定のポート(NodePort)を開放しておき、このポートに入ってくるトラフィックをサービスに属するPodへ転送する方式です。外部のユーザーは、クラスタのノードのIPアドレスとNodePortを通じてサービスにアクセスできます。
このとき、NATは重要な役割を果たし、特にDNAT(Destination NAT)とSNAT(Source NAT)が同時に発生します。外部から特定のノードのNodePortへトラフィックが入ると、Kubernetesネットワークは、このトラフィックを最終的に当該サービスを提供するPodへ転送しなければなりません。この過程で、まずDNATが発生し、パケットの宛先IPアドレスとポート番号がPodのIPアドレスとポート番号に変更されます。
例えば、クラスタ外部のユーザー(203.0.113.10、ポート: 30000)が、Kubernetesクラスタのあるノード(192.168.1.5)のNodePort(30001)を通じてサービスにアクセスすると仮定しましょう。このサービスは内部的に、IPアドレスが10.0.2.15でポートが8080のPodを指しているものとします。
1外部ユーザー (203.0.113.10:30000) ==> Kubernetesノード (外部:192.168.1.5:30001 / 内部: 10.0.1.1:42132) ==> Kubernetes Pod (10.0.2.15:8080)
ここで、Kubernetesノードは、外部からアクセス可能なノードのIPアドレス192.168.1.5と、内部のKubernetesネットワークで有効なIPアドレス10.0.1.1の両方を持っています。(使用するCNIの種類によってこれに関するポリシーは多様になりますが、本稿ではCiliumを基準に説明を進めます。)
外部ユーザーの要求がノードに到着すると、ノードはこの要求を処理するPodへ転送しなければなりません。このとき、ノードは次のようなDNATルールを適用して、パケットの宛先IPアドレスとポート番号を変更します。
1# ノードがPodへ送信しようと準備しているTCPパケット
2# DNAT 適用後
3| src ip       | src port | dst ip    | dst port |
4---------------------------------------------------
5| 203.0.113.10 | 30000    | 10.0.2.15 | 8080    |
ここで重要な点は、Podがこの要求に対する応答を送信する際、送信元IPアドレスは自身のIPアドレス(10.0.2.15)であり、宛先IPアドレスは要求を送信した外部ユーザーのIPアドレス(203.0.113.10)になるということです。この場合、外部ユーザーは自分が要求したことのない存在しないIPアドレスから応答を受け取ることになり、そのパケットを単に破棄してしまいます。そのため、Kubernetesノードは、Podが外部へ応答パケットを送信する際にSNATを追加で実行し、パケットの送信元IPアドレスをノードのIPアドレス(192.168.1.5または内部ネットワークのIPである10.0.1.1、この場合は10.0.1.1で進めます)に変更します。
1# ノードがPodへ送信しようと準備しているTCPパケット
2# DNAT、SNAT 適用後
3| src ip       | src port | dst ip    | dst port |
4---------------------------------------------------
5| 10.0.1.1     | 40021    | 10.0.2.15 | 8080     |
これでこのパケットを受け取ったPodは、最初にNodePortで要求を受けたノードへ応答を返し、ノードは同じDNAT、SNATの過程を逆に適用して、外部ユーザーへ情報を返すことになります。この過程で、各ノードは次のような情報を保存することになるでしょう。
1# ノード内部のDNATテーブル
2| original ip     | original port | destination ip  | destination port |
3------------------------------------------------------------------------
4| 192.168.1.5     | 30001         | 10.0.2.15       | 8080             |
5
6# ノード内部のSNATテーブル
7| original ip     | original port | destination ip  | destination port |
8------------------------------------------------------------------------
9| 203.0.113.10    | 30000         | 10.0.1.1        | 42132            |
本論
一般的にLinuxにおいて、こうしたNATの過程はiptablesを通じて、conntrackと呼ばれるサブシステムによって管理され、動作します。実際、flannelやcalicoなどの他のCNIプロジェクトでは、これを活用して上記のような問題を処理しています。ただし問題は、CiliumがeBPFという技術を用いることで、このような伝統的なLinuxネットワークスタックを丸ごと無視してしまうという点です。🤣
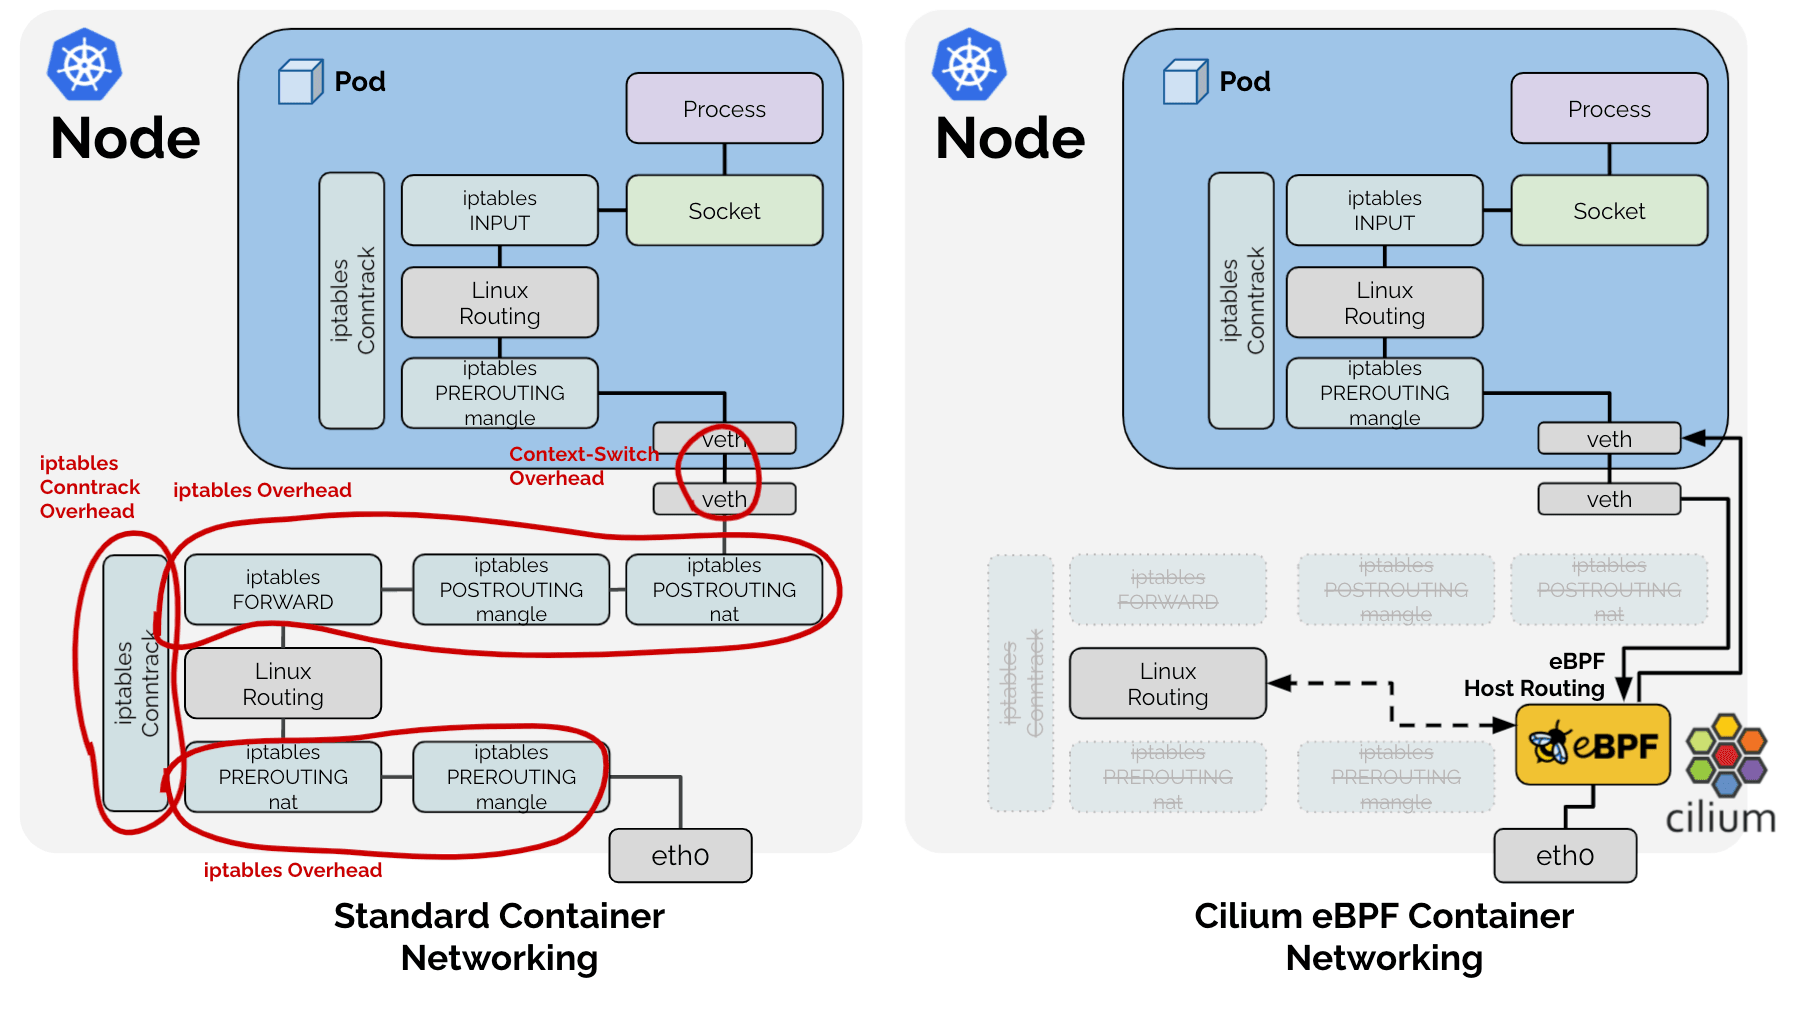
その結果、Ciliumは上の図で既存のLinuxネットワークスタックが担っていた業務のうち、Kubernetesの状況で必要な機能だけを直接実装する道を選びました。そのため、前述のSNAT過程についても、Ciliumは SNATテーブルを LRU Hash Map(BPF_MAP_TYPE_LRU_HASH)の形式で直接管理しています。
1# Cilium SNATテーブル
2# !わかりやすい説明のための例。実際の定義は: https://github.com/cilium/cilium/blob/v1.18.0-pre.1/bpf/lib/nat.h#L149-L166
3| src ip     | src port | dst ip  | dst port | protocol, conntrack 等その他のメタデータ
4----------------------------------------------
5|            |          |         |          |
そして、Hash Tableである以上、高速な検索のためにキー値が存在し、src ip、src port、dst ip、dst portの組み合わせをキー値として使用しています。
問題認識
現象 - 1: 検索
こうした設計のため発生する問題が一つあります。eBPFを通過するパケットが、NAT過程においてSNATまたはDNATを実行する必要があるパケットかどうかを検証するために、上記のHash Tableを検索しなければならないのですが、先に見てきたように、SNAT過程には二種類のパケットが存在します。1. 内部から外部へ出ていくパケット、そして2. その応答として外部から内部へ入ってくるパケットです。この二つのパケットはいずれもNAT過程での変換が必要でありながら、src ipとport、dst ipとportの値が入れ替わるという特徴があります。
そのため、迅速な検索のためには、srcとdstが入れ替わった値をkeyとして、Hash Tableに値をもう一つ追加するか、あるいはSNATと無関係なパケットであっても、すべてのパケットについて同じHash Tableを二回検索する必要があります。当然ながらCiliumは、より良い性能のためにRevSNATという名称で、同じデータを二回挿入する方式を採用しました。
現象 - 2: LRU
さらに、上記の問題とは別に、すべてのハードウェアに無限のリソースが存在することはできず、特に高速な性能が求められるハードウェアレベルのロジックである以上、動的なデータ構造も使用できない状況で、リソースが不足したときには既存のデータをevictする必要があります。Ciliumでは、これをLinuxで基本的に提供される標準データ構造であるLRU Hash Mapを使用することで解決しました。
現象1 + 現象2 = コネクションの喪失
https://github.com/cilium/cilium/issues/31643
つまり、一つのSNATされたTCP(あるいはUDP)コネクションについて、
- 一つのHash Tableに、送信されるパケットと受信されるパケットに対する同じデータが二度記録されており、
- LRUロジックによって、いつでもそのうち一方のデータが失われうる状況において、
外部へ出ていくパケットまたは外部から入ってくるパケットに対するNAT情報(以下 entry)のうち一つでもLRUによって消えてしまうと、正常にNATを実行できず、コネクション全体の喪失につながりうる、というのがその内容です。
解決
ここで、先に言及した次のPRが登場します。
bpf:nat: restore a NAT entry if its REV NAT is not found
bpf:nat: Restore ORG NAT entry if it's not found
従来は、パケットがeBPFを通過する際に、SNATテーブルでsrc ip、src port、dst ip、dst portの組み合わせでキーを作成し、検索を試みていました。もしキーが存在しなければ、SNAT規則に従って新しいNAT情報を生成し、テーブルに記録していました。新しいコネクションの場合、これは正常な通信につながりますが、もしLRUによって意図せずキーが削除された場合には、既存の通信で使用していたポートとは異なるポートで新たにNATが実行されることになり、パケットを受信する側は受信を拒否し、RSTパケットとともにコネクションが終了することになります。
ここで上記のPRが採用したアプローチは単純です。
どちらの方向であれ、パケットが一度観測されたら、その逆方向に対するentryも新たに更新しよう。
どちらの方向であれ通信が観測されると、双方のentryがともに新たに更新されることで、LRUロジックのEviction優先順位の対象から遠ざかり、これによって片方のentryだけが削除されて通信全体が崩壊するシナリオの可能性を低くすることができます。
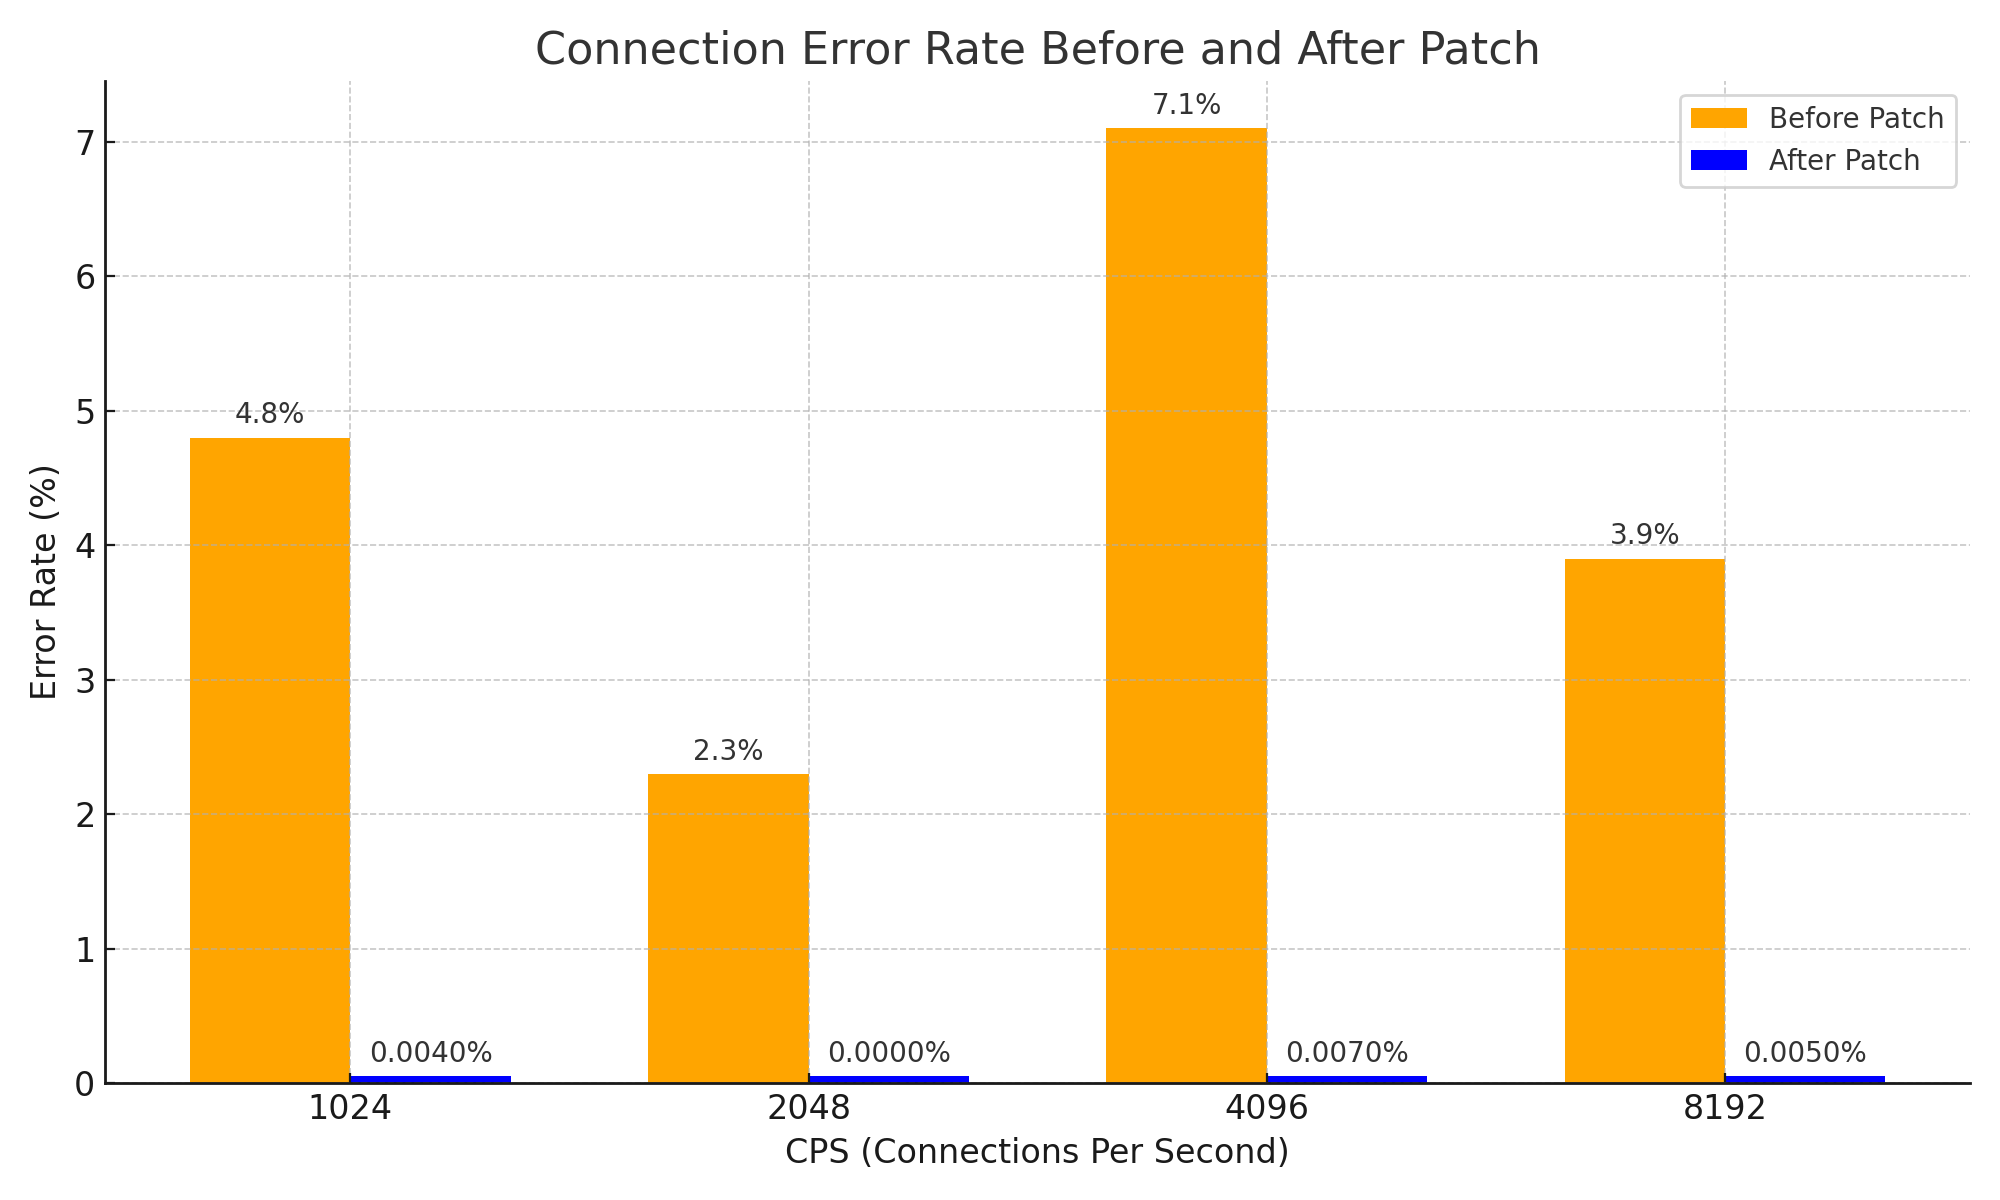
これは非常に単純なアプローチであり、簡単なアイデアのように見えるかもしれませんが、このアプローチによって、応答パケットに対するNAT情報が先に期限切れとなり接続が切れる問題を効果的に解決し、システムの安定性を大きく向上させることができました。また、ネットワークの安定性という側面で、次のような成果を成し遂げた重要な改善であるといえます。
結論
私は、このPRがNATがどのように動作するかという基礎的なCS知識から始まり、複雑なシステム内部でも単純なアイデア一つがどれほど大きな変化をもたらしうるかを示す、非常に良い事例だと考えています。
ああ、もちろん複雑なシステムの事例を今回の記事で直接お見せすることはできませんでした。しかし、このPRを正しく理解するために、私はDeepSeek V3 0324にPleaseという言葉まで付けながら、3時間近く頼み込み、その結果、Ciliumに関する知識+1と、以下のような図を一つ得ることができました。😇

そして、イシューとPRを読みながら、私が以前作った何かのせいでイシューが発生したのではないかという不吉な予感に対する埋め合わせとして、このような記事を書いてみました。
後記 - 1
参考までに、この問題には非常に効果的な回避方法があります。問題が発生する根本原因はNATテーブルの容量不足なので、NATテーブルのサイズを大きくすればよいのです。:-D
誰かが同じ問題に遭遇したとき、イシューも残さずにNATテーブルのサイズだけ増やして立ち去ってしまってもおかしくない状況で、自身と直接関係のないイシューであるにもかかわらず、徹底的に分析して理解し、客観的な根拠データとともにCiliumエコシステムへの貢献までしてくださったgyutaebさんの情熱に感嘆し、尊敬しています。
この記事を書こうと決心したきっかけでした。
後記 - 2
この話は、Go言語を専門に扱うGosudaとは実は直接的に合うテーマではありません。しかし、Go言語とクラウドエコシステムは密接に関連しており、Ciliumの貢献者たちもGo言語にある程度の素養があるため、個人ブログに載せられる内容をGosudaに持ってきてみました。
管理者の一人(私自身)の許可があったため、おそらく問題ないと考えています。
もし問題があるとお考えでしたら、いつ削除されるかわからないので、すぐにPDFで保存しておいてください。;)
後記 - 3
今回の記事の執筆には、ClineとLlama 4 Maverickの助けを大いに受けました。Geminiで分析を始め、DeepSeekに頼み込みましたが、実際に助けを得たのはLlama 4でした。Llama 4は良いです。ぜひ使ってみてください。