 GoSuda
Randflake ID: Sparx64ブロック暗号を用いた分散64ビット一意ID生成

ある状況を考えてみましょう。外部の第三者が次の番号や前の番号を予測できないようにしながら、一意の64ビット乱数を生成する必要があるとします。
ここでは、8バイトの乱数値を生成し、それがデータベース内に既に存在するかを確認し、一意であれば保存する、という方法が考えられます。
しかしながら、この方法にはいくつかの欠点があります。一意性を保証するためには、生成したすべての番号をデータベースに保存しなければなりません。また、データベースへの少なくとも一回のラウンドトリップが必要となるため、特にスケーラビリティが重要となる分散環境においては、レイテンシの問題が生じます。
これらの問題を解決するために、我々は分散型、一様性、予測不可能性、一意性を備えた乱数ID生成器であるRandflake IDを導入します。
Randflake IDはどのように機能するか
Randflake IDは、X(旧Twitter)によって開発され、広く利用されているk-sortable ID生成方式であるSnowflake IDに着想を得ています。
Snowflake IDは、現在のタイムスタンプ、ノードID、およびローカルカウンタを用いて識別子を生成します。
我々は、このアプローチをさらに発展させ、乱数による一意ID生成へと拡張するとともに、新たに秘密鍵の要素を追加しました。
主要な着想は、既存の一意ID生成器にブロック暗号層を追加することにより、数値間の関係を予測することが実質的に不可能となるようにすることです。
ブロック暗号とは、固定長の平文ブロックを、同じ長さの暗号文ブロックへと変換する基本的な暗号関数です。この変換は暗号鍵によって制御されます。ブロック暗号の特徴的な性質は可逆性にあります。すなわち、各一意の入力が一意の出力に対応し、その逆も成り立つよう、一対一(全単射)の関数でなければなりません。この性質は復号にとって不可欠であり、正しい鍵が適用された場合に暗号文から元の平文を復元することを可能にします。
ブロック暗号を一対一関数として用いることにより、各一意の入力が、定義された範囲内において対応する一意の出力を生成することを保証できます。
構造と設計上の考慮事項
これらの基本的概念を踏まえ、Randflake IDがこれらの着想を実際にどのように実装しているかを検討します。
Randflake IDの構造は、秒精度の30ビットUnixタイムスタンプ、17ビットのノード識別子、17ビットのローカルカウンタ、そしてsparx64アルゴリズムに基づく64ビットブロック暗号から構成されています。
設計上の決定事項は以下のとおりです。
Google Cloud PlatformのいくつかのVMインスタンスは、0.2ミリ秒の精度でクロックを同期できますが、そのような精度はパブリックインターネットや他のクラウドプロバイダでは利用できません。
ノード間でクロックを効果的に同期できるのは数ミリ秒の分解能に限られるため、秒精度を採用しました。
17ビットのノード識別子は、同時に131072個の個別の生成器を割り当てることを可能にし、プロセス単位、コア単位、またはスレッド単位で割り当てることができます。
高スループットのシステムにおいては、17ビットのローカルカウンタでは不十分となる可能性があります。スループットに対応するため、単一のプロセスまたはスレッド内で、それぞれ異なるノードIDを持つ複数の生成器を割り当てることができます。
我々は64ビットブロック暗号として、現代的な軽量ARXベースのブロック暗号であるsparx64を採用しました。
Randflake IDは内部的なトレーサビリティを備えており、その発生元のノードIDおよびタイムスタンプは、秘密鍵を保有する者にのみ明らかになります。
理論上の最大スループットは17,179,869,184 ID/秒であり、これはほとんどのグローバル規模のアプリケーションにとって十分な水準です。
Randflake ID生成の擬似コード
Randflake IDの生成過程をさらに説明するために、以下のPythonによる擬似コードは簡略化された実装を示しています。
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# 定数
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # 2024年10月27日(日曜日)3:33:20 AM UTC
 7
 8# ビット割り当て
 9RANDFLAKE_TIMESTAMP_BITS = 30  # タイムスタンプ用30ビット(寿命34年)
10RANDFLAKE_NODE_BITS = 17  # ノードID用17ビット(最大131072ノード)
11RANDFLAKE_SEQUENCE_BITS = 17  # シーケンス用17ビット(最大131072シーケンス)
12
13# 導出定数
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
ノードID割り当てのリース機構を備えた、本番環境向けのRandflakeの実装は、GitHubにて公開されています。
その他の考慮事項
本節では、Randflake IDを実装するうえでのその他の考慮事項について検討します。
ノードID の調整
我々は、リースに基づくノードID調整を推奨します。
この方式では、中央の調整サービスが各生成器に一意のノードIDを割り当てます。
このノードIDは、一意性を確保するためにリース期間中は再割り当てされず、調整サービスとの頻繁な通信の必要性を低減します。
リースを保持する生成器は、更新条件が満たされている場合、調整サービスにリースの更新を要求することができます。
更新条件とは、リースが更新されるために満たされなければならない一連の基準を指し、例えば生成器がなお稼働中であり、ノードIDを必要としていることなどが含まれます。
リース保有者とは、ノードIDの範囲を現在保持している主体を指します。
リースは、その有効期間内にある場合に有効かつ期限切れではないとみなされます。
このようにして、リース更新期間ごとのラウンドトリップを一回に抑えることができ、分散システムにおけるレイテンシを最小化し、効率を向上させることができます。
誤ったクロックへの対策
リースサービスは、リースを割り当てる際にタイムスタンプの整合性を検証しなければなりません。割り当てられるリースの開始時刻は、直前のリースの開始時刻以上でなければなりません。
生成器は、現在のタイムスタンプがリースの開始時刻より小さい場合、またはリースの終了時刻より大きい場合には、要求を拒否すべきです。
この手順は、クロックが後方へ飛んだ場合に生成されるIDの一意性を保護するうえで重要です。例えば、クロックが後方へ飛ぶと、既に割り当てられたリースより早い開始時刻を持つ新たなリースが割り当てられる可能性があり、その結果、重複するIDが生成されるおそれがあります。既存のリース期間内のタイムスタンプを伴う要求を拒否することで、このような事態を防ぎ、IDの一意性を維持します。
IDの分布の一様性
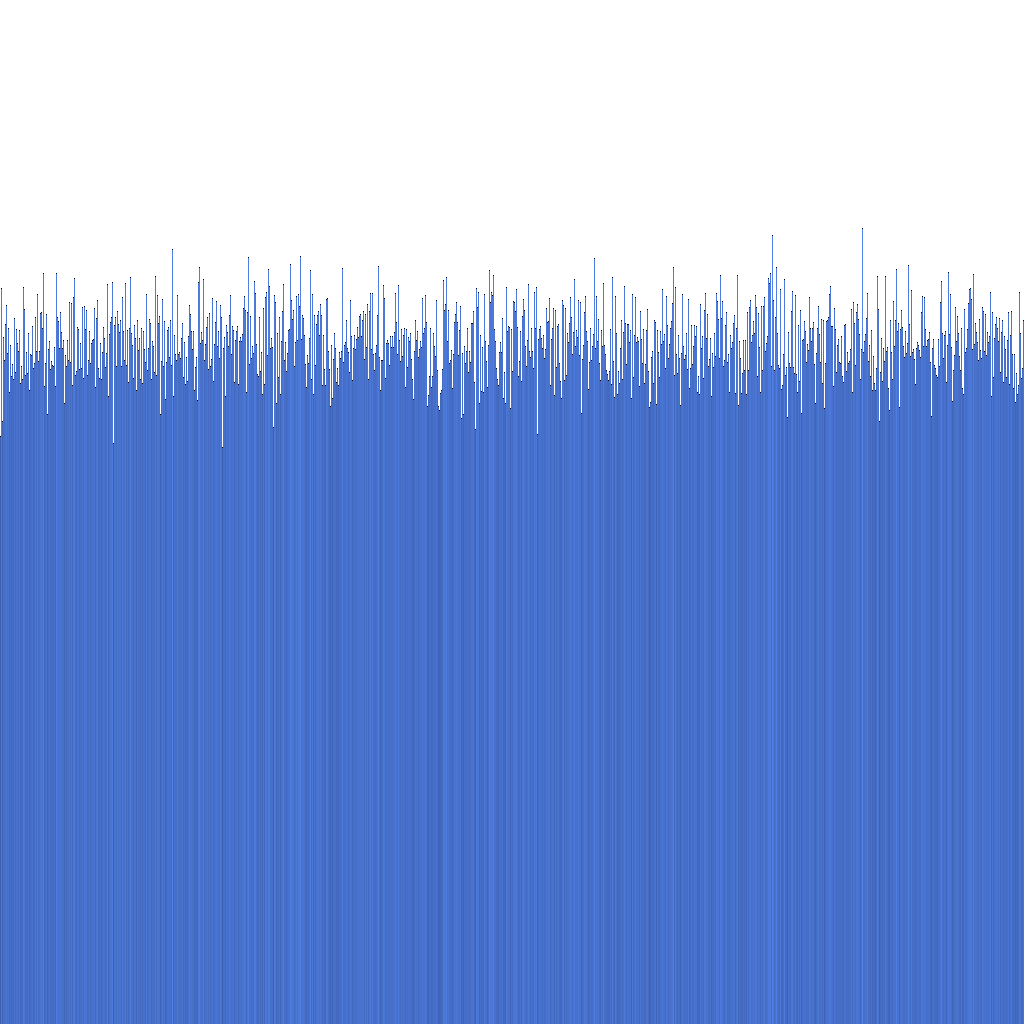
上記のヒストグラムから、生成されたRandflake IDの分布が非常に一様であることが分かります。このことは、ID の分布をそのままシャーディングキーとして利用できることを示唆しています。
結論
本稿では、SnowflakeとSparx64の利点を組み合わせた新しいID生成アルゴリズムであるRandflakeを紹介しました。
本稿が、Randflakeとその実装について包括的な理解を提供できたことを願っています。
Randflakeの完全なソースコードはGitHubにて入手できます。
ご質問やご提案がございましたら、遠慮なくお問い合わせください。また、Randflakeの改善や他のプログラミング言語への実装に協力してくださる貢献者を募集しています。
我々は、Randflakeおよびsnowflake向けの本番環境対応の調整サービスのリリースを計画しており、これはGitHubにてオープンソースとして公開される予定です。続報をお待ちください。