 GoSuda
Randflake ID: Sparx64 블록 암호를 활용한 분산 64비트 고유 ID 생성

다음과 같은 상황을 생각해 보겠습니다. 외부 주체가 다음 번호나 이전 번호를 예측할 수 없어야 하는 상황에서 고유한 64비트 난수를 생성해야 합니다.
여기서는 8바이트 난수 값을 생성하고, 데이터베이스에 이미 존재하는지 확인한 다음, 고유한 경우에만 저장할 수 있습니다.
그러나 이 방법에는 몇 가지 단점이 있습니다. 고유성을 보장하려면 생성된 모든 번호를 데이터베이스에 저장해야 합니다. 또한 최소 한 번의 데이터베이스 왕복이 필요하기 때문에, 확장성이 중요한 분산 환경에서 지연 시간 문제가 발생합니다.
이러한 문제를 해결하기 위해 우리는 분산형, 균일 분포, 예측 불가능, 고유성을 갖춘 난수 ID 생성기인 Randflake ID를 소개합니다.
Randflake ID는 어떻게 작동하는가?
Randflake ID는 널리 사용되는 k-정렬 ID 생성 메커니즘인 Snowflake ID에서 영감을 얻었으며, 이는 X(구 트위터)가 개발했습니다.
Snowflake ID는 현재 타임스탬프, 노드 ID, 로컬 카운터를 사용하여 식별자를 생성합니다.
우리는 이 접근 방식을 난수 고유 ID 생성으로 더욱 확장하였으며, 새로운 비밀 키 요소를 추가했습니다.
핵심 아이디어는 기존의 고유 ID 생성기에 블록 암호 계층을 추가하여 숫자 간의 관계를 예측하는 것을 불가능하게 만드는 것입니다.
블록 암호는 고정 길이의 평문 블록을 동일한 길이의 암호문 블록으로 변환하는 기본적인 암호학적 함수입니다. 이 변환은 암호학적 키에 의해 제어됩니다. 블록 암호의 구별되는 특성은 가역성으로, 각각의 고유한 입력이 고유한 출력에 대응하고 그 역also도 성립하도록 일대일(전단사) 함수여야 합니다. 이 속성은 복호화에 필수적이며, 올바른 키가 적용되면 암호문으로부터 원래의 평문을 복원할 수 있게 합니다.
블록 암호를 일대일 함수로 사용함으로써, 우리는 각각의 고유한 입력이 정의된 범위 내에서 대응하는 고유한 출력을 생성함을 보장할 수 있습니다.
구조와 설계 고려 사항
이러한 기본 개념을 바탕으로, Randflake ID가 이러한 아이디어를 실제로 어떻게 구현하는지 살펴보겠습니다.
Randflake ID 구조는 초 단위 정밀도의 30비트 유닉스 타임스탬프, 17비트 노드 식별자, 17비트 로컬 카운터, 그리고 sparx64 알고리즘을 기반으로 한 64비트 블록 암호로 구성됩니다.
다음은 몇 가지 설계 결정 사항입니다.
Google Cloud Platform의 일부 VM 인스턴스는 0.2ms 정밀도 내에서 클록을 동기화할 수 있지만, 그러한 수준의 정확도는 공용 인터넷이나 다른 클라우드 제공업체에서는 사용할 수 없습니다.
노드 간 클록을 효과적으로 동기화할 수 있는 해상도가 수 밀리초 수준에 불과하므로, 초 단위 정밀도를 선택했습니다.
17비트 노드 식별자는 동일한 시점에 131072개의 개별 생성기를 허용하며, 이는 프로세스별, 코어별, 또는 스레드별 방식으로 할당될 수 있습니다.
높은 처리량의 시스템에서는 17비트 로컬 카운터가 부족할 수 있습니다. 처리량에 맞추기 위해, 각각 고유한 노드 ID를 가진 여러 생성기를 할당하여 단일 프로세스나 스레드에서 작동하도록 할 수 있습니다.
우리는 최신의 경량 ARX 기반 블록 암호인 sparx64를 64비트 블록 암호로 채택했습니다.
Randflake ID는 내부 추적성을 제공하며, 비밀 키를 소유한 자에게만 발생 노드 ID와 타임스탬프를 드러냅니다.
이론상 최대 처리량은 17,179,869,184 ID/s이며, 이는 대부분의 전 세계 규모 애플리케이션에 충분합니다.
Randflake ID 생성 의사 코드
Randflake ID 생성 과정을 더 자세히 설명하기 위해, 다음의 Python 의사 코드는 단순화된 구현을 제공합니다.
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# 상수
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # 2024년 10월 27일 일요일 오전 3:33:20 UTC
 7
 8# 비트 할당
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 타임스탬프용 30비트 (수명 34년)
10RANDFLAKE_NODE_BITS = 17  # 노드 ID용 17비트 (최대 131072개 노드)
11RANDFLAKE_SEQUENCE_BITS = 17  # 시퀀스용 17비트 (최대 131072개 시퀀스)
12
13# 파생 상수
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
노드 ID 임대 메커니즘을 포함한 프로덕션 준비 완료 구현은 GitHub에서 확인할 수 있습니다.
기타 고려 사항
이 절에서는 Randflake ID 구현에 관한 몇 가지 추가적인 고려 사항을 논의합니다.
노드 ID 조정
우리는 임대 기반 노드 ID 조정을 제안합니다.
이 방식에서는 중앙 조정 서비스가 각 생성기에 고유한 노드 ID를 할당합니다.
고유성을 보장하기 위해 이 노드 ID는 임대 기간 동안 재할당되지 않으며, 이로 인해 조정 서비스와의 빈번한 통신 필요성이 줄어듭니다.
임대를 보유한 생성기는 갱신 조건이 충족되면 조정 서비스에 임대 갱신을 요청할 수 있습니다.
갱신 조건이란 임대가 갱신되기 위해 충족되어야 하는 일련의 기준을 의미하며, 예를 들어 생성기가 여전히 활성 상태이고 노드 ID를 계속 필요로 하는 경우가 이에 해당합니다.
임대 보유자는 현재 노드 ID 범위의 보유자입니다.
임대는 유효 기간 내에 있는 경우 활성 상태이며 만료되지 않은 것으로 간주됩니다.
이러한 방식으로 임대 갱신 주기마다 왕복 통신을 한 번으로 줄일 수 있어, 분산 시스템에서 지연 시간을 최소화하고 효율성을 향상시킬 수 있습니다.
잘못된 클록에 대한 완화 방안
임대 서비스는 임대를 할당할 때 타임스탬프의 일관성을 검사해야 합니다. 할당되는 임대의 시작 시간은 마지막 임대의 시작 시간보다 크거나 같아야 합니다.
생성기는 현재 타임스탬프가 임대 시작 시간보다 작거나 임대 종료 시간보다 큰 경우 요청을 거부해야 합니다.
이 절차는 클록이 뒤로 이동할 때 생성된 ID의 고유성을 보호하는 데 중요합니다. 예를 들어, 클록이 뒤로 이동하면 이전에 할당된 임대보다 이른 시작 시간을 가진 새 임대가 할당될 수 있으며, 이는 중복 ID의 생성으로 이어질 수 있습니다. 기존 임대 기간 내의 타임스탬프를 가진 요청을 거부함으로써 이러한 상황을 방지하고 ID의 고유성을 유지합니다.
ID 분포의 균일성
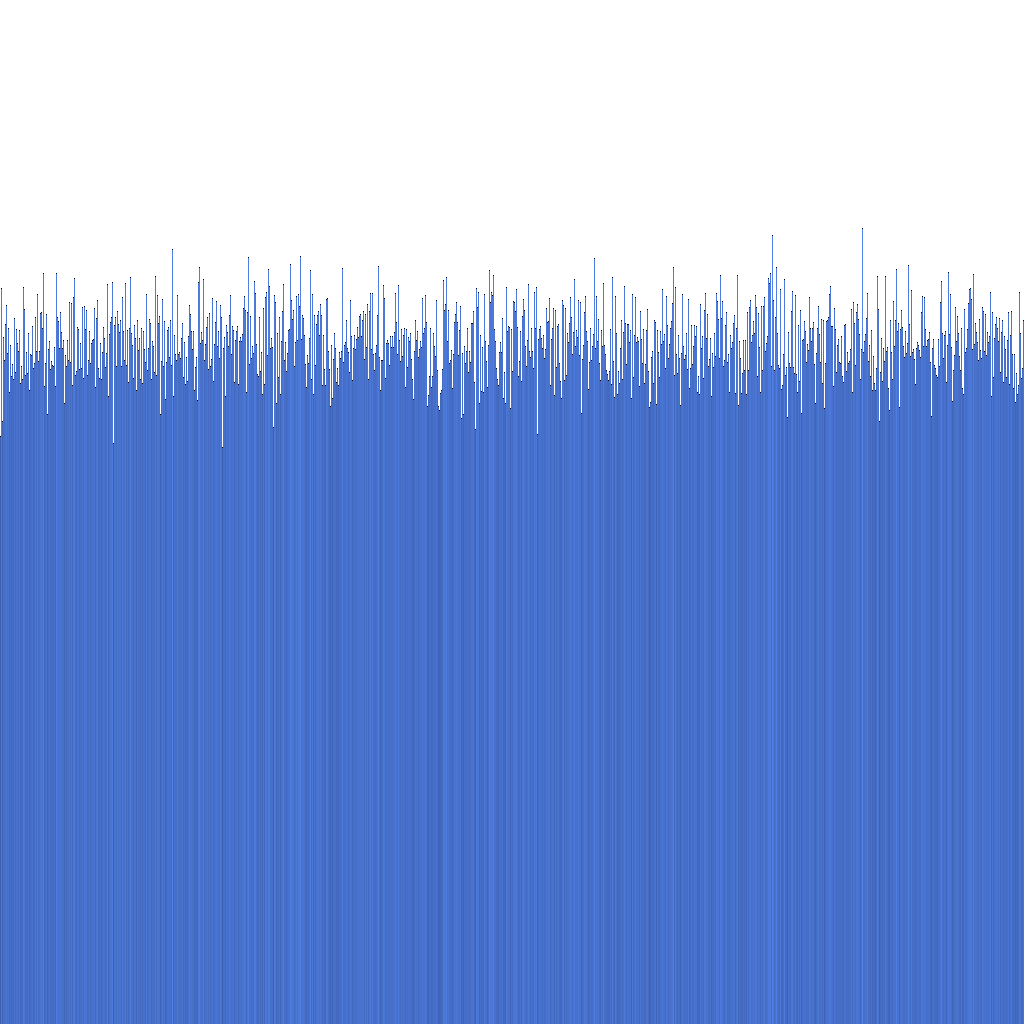
위의 히스토그램을 기반으로, 생성된 Randflake ID의 분포가 매우 균일하다는 것을 확인할 수 있습니다. 이는 ID 분포를 샤딩 키로 직접 사용할 수 있음을 시사합니다.
결론
본 글에서는 Snowflake와 Sparx64의 장점을 결합한 새로운 ID 생성 알고리즘인 Randflake를 소개했습니다.
이 글이 Randflake와 그 구현에 대한 포괄적인 이해를 제공했기를 바랍니다.
Randflake의 전체 소스 코드는 GitHub에서 확인하실 수 있습니다.
질문이나 제안 사항이 있으시면 언제든지 연락해 주십시오. 또한 Randflake를 개선하고 다른 프로그래밍 언어로 구현하는 데 도움을 줄 기여자를 찾고 있습니다.
Randflake와 Snowflake를 위한 프로덕션 준비 완료 조정 서비스를 출시할 계획이며, 이는 GitHub에서 오픈소스로 공개될 예정입니다. 업데이트를 기대해 주십시오!