 GoSuda
Randflake ID: Gedistribueerde 64-Bit Unique ID-generatie met Sparx64 Block Cipher

Overweeg een situatie waarin we unieke 64-bits willekeurige getallen moeten genereren, en waarin externe partijen het volgende of vorige getal niet kunnen voorspellen.
Hierbij kunnen we een willekeurige waarde van 8 bytes genereren, controleren of deze al in de database bestaat, en deze vervolgens opslaan indien ze uniek is.
Deze methode heeft echter verschillende nadelen. We moeten elk gegenereerd getal in een database opslaan om uniciteit te waarborgen. De vereiste van minstens één round trip naar de database veroorzaakt latentieproblemen, met name in een gedistribueerde omgeving waarin schaalbaarheid cruciaal is.
Om deze problemen op te lossen introduceren wij Randflake ID: een gedistribueerde, uniforme, onvoorspelbare en unieke generator voor willekeurige ID's.
Hoe werkt Randflake ID?
Randflake ID is geïnspireerd op Snowflake ID, het algemeen gebruikte, k-sorteerbare ID-generatiemechanisme dat is ontwikkeld door X (voorheen Twitter).
Snowflake ID gebruikt de huidige tijdstempel, een node-ID en een lokale teller om een identifier te genereren.
Wij hebben deze aanpak verder uitgebreid voor het genereren van willekeurige unieke ID's en een nieuw geheim sleurelement toegevoegd.
Het kernidee is het toevoegen van een blokcijferlaag aan de bestaande generator voor unieke ID's, om te bereiken dat de relatie tussen getallen niet voorspelbaar is.
Een blokcijfer is een fundamentele cryptografische functie die een blok platte tekst van vaste lengte transformeert in een cijfertekstblok van dezelfde lengte. Deze transformatie wordt bepaald door een cryptografische sleutel. Het onderscheidende kenmerk van een blokcijfer is de omkeerbaarheid ervan: het moet een één-op-één (bijectieve) functie zijn, die ervoor zorgt dat elke unieke invoer overeenkomt met een unieke uitvoer, en omgekeerd. Deze eigenschap is cruciaal voor decryptie, waarbij de oorspronkelijke platte tekst uit de cijfertekst kan worden hersteld wanneer de juiste sleutel wordt toegepast.
Door een blokcijfer als één-op-één functie te gebruiken, kunnen we garanderen dat elke unieke invoer een overeenkomstige unieke uitvoer oplevert binnen het gedefinieerde bereik.
De structuur en ontwerpoverwegingen
Voortbouwend op deze fundamentele concepten bekijken we hoe Randflake ID deze ideeën in de praktijk implementeert.
De structuur van Randflake ID bestaat uit een 30-bits unix-tijdstempel met secondeprecisie, een 17-bits node-identifier, een 17-bits lokale teller en een 64-bits blokcijfer gebaseerd op het sparx64-algoritme.
Hier zijn enkele ontwerpbeslissingen:
Sommige VM-instanties in Google Cloud Platform kunnen de klok synchroniseren met een precisie van 0,2 ms, maar dat niveau van nauwkeurigheid is niet beschikbaar op het publieke internet of bij andere cloudproviders.
Wij hebben voor secondeprecisie gekozen omdat we de klok tussen nodes slechts binnen enkele milliseconden effectief kunnen synchroniseren.
Een 17-bits node-identifier maakt 131072 afzonderlijke generatoren op hetzelfde moment mogelijk, die per proces, per core of per thread kunnen worden toegewezen.
In systemen met een hoge doorvoer kan een 17-bits lokale teller ontoereikend zijn. Om de doorvoer bij te houden, kunnen we meerdere generatoren, elk met een afzonderlijke node-ID, laten werken binnen één proces of thread.
Wij hebben sparx64 gekozen als 64-bits blokcijfer, een modern, lichtgewicht blokcijfer gebaseerd op ARX.
Randflake ID's bieden interne traceerbaarheid, waarbij de oorspronkelijke node-ID en tijdstempel alleen worden onthuld aan degenen die over de geheime sleutel beschikken.
De theoretische maximale doorvoer bedraagt 17.179.869.184 ID's per seconde, wat voldoende is voor de meeste wereldwijde toepassingen.
Pseudocode van de Randflake ID-generatie
Om het Randflake ID-generatieproces verder toe te lichten, biedt de volgende Python-pseudocode een vereenvoudigde implementatie:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Constanten
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Zondag 27 oktober 2024 03:33:20 UTC
 7
 8# Toewijzing van bits
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bits voor tijdstempel (levensduur van 34 jaar)
10RANDFLAKE_NODE_BITS = 17  # 17 bits voor node-id (max. 131072 nodes)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bits voor sequentie (max. 131072 sequenties)
12
13# Afgeleide constanten
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Een productieklare implementatie van Randflake, met een node-ID-leasemechanisme, is beschikbaar op GitHub.
Overige overwegingen
In deze sectie bespreken we enkele aanvullende overwegingen voor de implementatie van Randflake ID.
Coördinatie van node-ID's
Wij stellen een op leases gebaseerde coördinatie van node-ID's voor.
Bij deze aanpak wijst een centrale coördinatieservice aan elke generator een unieke node-ID toe.
Deze node-ID wordt tijdens de leaseperiode niet opnieuw toegewezen om de uniciteit te waarborgen, waardoor de noodzaak voor frequente communicatie met de coördinatieservice afneemt.
De generator die de lease bezit, kan een verlenging van de lease bij de coördinatieservice aanvragen wanneer aan de verlengingsvoorwaarde is voldaan.
De verlengingsvoorwaarde verwijst naar een reeks criteria waaraan moet worden voldaan opdat de lease kan worden verlengd, bijvoorbeeld dat de generator nog actief is en de node-ID nog nodig heeft.
De leaseholder is de huidige houder van het node-ID-bereik.
De lease wordt als actief en niet verlopen beschouwd wanneer deze binnen de geldige tijdsperiode valt.
Op deze manier kunnen we het aantal round trips beperken tot één per leaseverlengingsperiode, waardoor latentie wordt geminimaliseerd en de efficiëntie in gedistribueerde systemen wordt verbeterd.
Bescherming tegen een defecte klok
De leaseservice moet de consistentie van tijdstempels controleren bij het toewijzen van een lease. De toegewezen starttijd van de lease moet groter dan of gelijk zijn aan de starttijd van de vorige lease.
De generator moet het verzoek weigeren wanneer het huidige tijdstempel kleiner is dan de starttijd van de lease of groter is dan de eindtijd van de lease.
Deze procedure is belangrijk om de uniciteit van gegenereerde ID's te beschermen wanneer de klok achteruit springt. Als de klok bijvoorbeeld achteruit springt, zou een nieuwe lease kunnen worden toegewezen met een starttijd die eerder ligt dan die van een eerder toegewezen lease, wat mogelijk tot dubbele ID's kan leiden. Door verzoeken met tijdstempels binnen een bestaande leaseperiode te weigeren, voorkomen we dit scenario en behouden we de uniciteit van de ID's.
Uniformiteit van de ID-verdeling
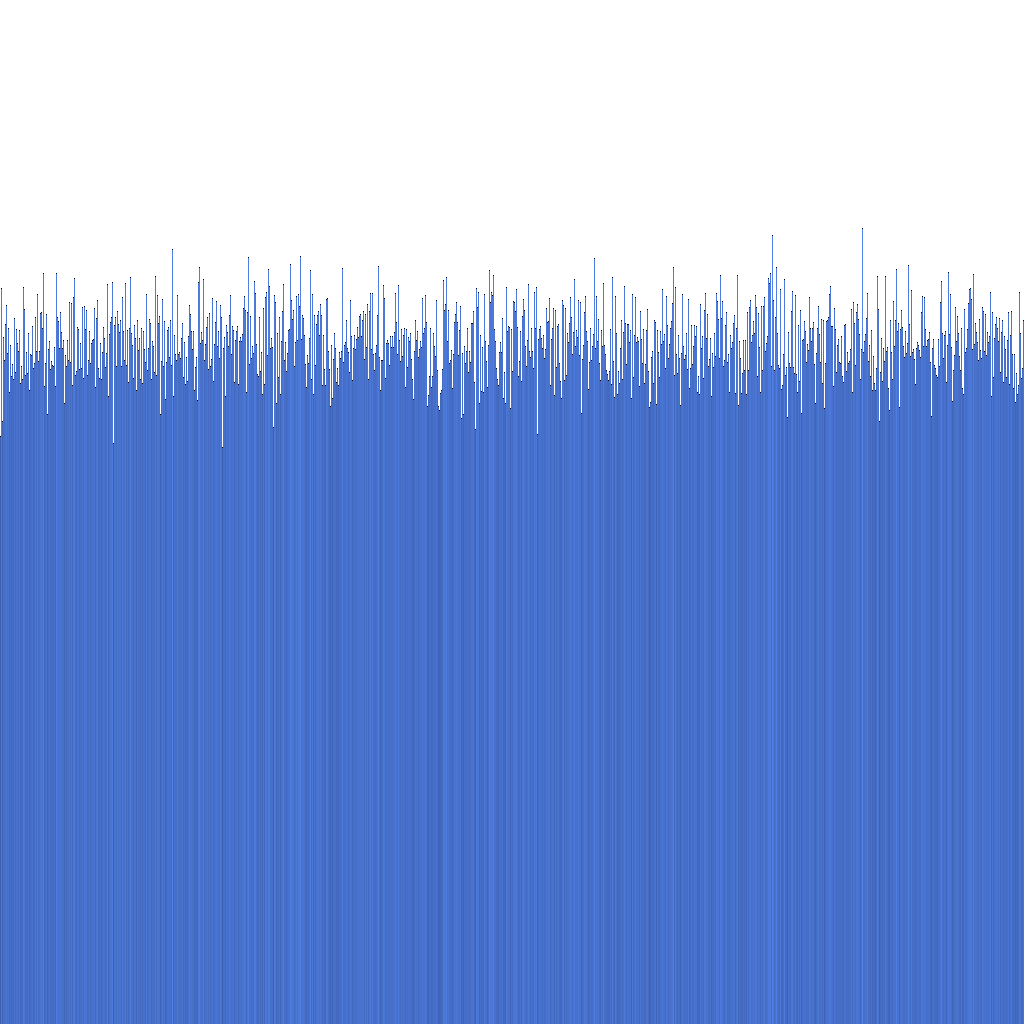
Op basis van het bovenstaande histogram zien we dat de verdeling van de gegenereerde Randflake ID's zeer uniform is. Dit suggereert dat de ID-verdeling direct kan worden gebruikt als shardingsleutel.
Conclusie
In dit artikel hebben we Randflake geïntroduceerd, een nieuw ID-generatiealgoritme dat de voordelen van Snowflake en Sparx64 combineert.
Wij hopen dat dit artikel u een uitgebreid inzicht heeft gegeven in Randflake en de implementatie ervan.
De volledige broncode van Randflake vindt u op GitHub.
Heeft u vragen of suggesties, aarzel dan niet om contact op te nemen. Wij zijn ook op zoek naar bijdragers die kunnen helpen Randflake te verbeteren en het in andere programmeertalen te implementeren.
Wij zijn van plan een productieklare coördinatieservice voor Randflake en Snowflake uit te brengen, die als open source op GitHub beschikbaar zal worden gesteld. Blijf op de hoogte voor updates!