 GoSuda
Zwiększanie responsywności dzięki klientowi cache Redis po stronie klienta

Czym jest Redis?
Przypuszczam, że niewiele osób nie zna Redisa. Mimo to, pokrótce wspomnę o kilku jego cechach, które można podsumować w następujący sposób.
- Operacje wykonywane są w jednym wątku, dzięki czemu wszystkie operacje mają atomowość.
- Dane są przechowywane i przetwarzane In-Memory, dlatego wszystkie operacje są szybkie.
- Redis może zapisywać WAL w zależności od opcji, dzięki czemu można szybko tworzyć kopię zapasową najnowszego stanu i odzyskiwać dane.
- Obsługuje wiele typów danych, takich jak Set, Hash, Bit, List, co zapewnia wysoką produktywność.
- Posiada dużą społeczność, dzięki czemu można dzielić się i otrzymywać różnorodne doświadczenia, problemy oraz rozwiązania.
- Jest rozwijany i eksploatowany przez długi czas, dzięki czemu cechuje go godna zaufania stabilność.
Przechodząc do sedna
Wyobraźmy sobie?
Co by było, gdyby pamięć podręczna Twojej usługi spełniała dwa poniższe warunki?
- Często przeglądane dane muszą być udostępniane użytkownikom w aktualnej postaci, lecz ich aktualizacje zachodzą nieregularnie, przez co pamięć podręczną trzeba często odświeżać.
- Dane nie ulegają aktualizacji, ale ta sama pamięć podręczna jest wielokrotnie odczytywana.
W pierwszym przypadku można rozważyć ranking popularności produktów w sklepie internetowym w czasie rzeczywistym. Jeśli ranking popularności produktów zapisany jest jako sorted set, odczytywanie go z Redisa za każdym razem, gdy użytkownik wchodzi na stronę główną, jest nieefektywne. W drugim przypadku, dane kursów walut są publikowane mniej więcej co 10 minut, jednak rzeczywiste odczyty następują bardzo często. Szczególnie często odwołujemy się do pamięci podręcznej dla kursów USD/KRW, JPY/KRW oraz CNY/KRW. W takich przypadkach efektywniejszym rozwiązaniem byłoby, aby serwer API posiadał lokalną, osobną pamięć podręczną, a po zmianie danych ponownie odczytywał je z Redisa i aktualizował lokalną pamięć.
Jak więc zrealizować takie działanie w strukturze baza danych - Redis - serwer API?
Czy nie wystarczy Redis PubSub?
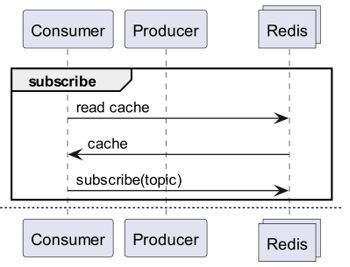
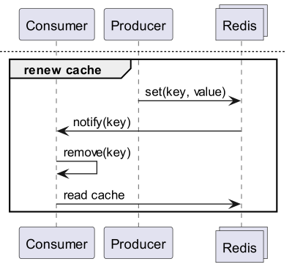
Podczas korzystania z pamięci podręcznej warto zasubskrybować kanał, na którym można otrzymywać informacje o aktualizacjach!
- Wtedy trzeba stworzyć logikę, która przy aktualizacji wysyła wiadomość.
- Dodatkowe operacje związane z PubSub wpływają na wydajność.
A gdyby Redis sam wykrywał zmiany?
Co jeśli użyjemy Keyspace Notification, aby otrzymywać powiadomienia o poleceniach dla danego klucza?
- Występuje kłopot, polegający na konieczności wcześniejszego zapisania i udostępnienia kluczy oraz poleceń używanych do aktualizacji.
- Na przykład, dla jednych kluczy poleceniem aktualizującym jest zwykły Set, dla innych LPush, a dla jeszcze innych RPush, SAdd lub SRem, co sprawia, że sytuacja staje się złożona.
- Znacznie zwiększa to prawdopodobieństwo błędów w komunikacji podczas rozwoju oraz błędów ludzkich w kodzie.
Co jeśli użyjemy Keyevent Notification, aby otrzymywać powiadomienia dla każdego polecenia?
- Konieczna jest subskrypcja wszystkich poleceń używanych do aktualizacji. Należy również odpowiednio filtrować klucze, które napływają.
- Na przykład, spośród wszystkich kluczy przychodzących z poleceniem Del, dla części z nich klient prawdopodobnie nie posiada lokalnej pamięci podręcznej.
- Może to prowadzić do niepotrzebnego marnotrawstwa zasobów.
Dlatego potrzebny jest Invalidation Message!
Czym jest Invalidation Message?
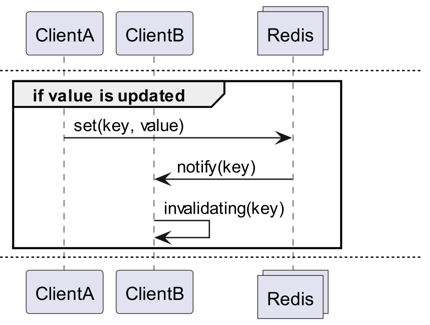
Invalidation Messages to koncepcja udostępniana w ramach Server Assisted Client-Side Cache, dodanego w Redis 6.0. Invalidation Message jest przekazywany zgodnie z następującym przebiegiem.
- Zakładamy, że ClientB odczytał już raz klucz.
- ClientA ustawia ten klucz na nowo.
- Redis wykrywa zmianę i wysyła do ClientB Invalidation Message, informując go, aby usunął pamięć podręczną.
- ClientB odbiera tę wiadomość i podejmuje odpowiednie działania.
Jak to się używa?
Podstawowa struktura działania
Klient połączony z Redisem wykonuje CLIENT TRACKING ON REDIRECT <client-id>, aby otrzymywać Invalidation Message. Następnie klient, który ma otrzymywać wiadomości, subskrybuje SUBSCRIBE __redis__:invalidate, aby odbierać Invalidation Message.
default tracking
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
broadcasting tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
Implementacja! Implementacja! Implementacja!
Redigo + Ristretto
Samo wyjaśnienie w ten sposób sprawia, że trudno wiedzieć, jak to faktycznie zastosować w kodzie. Dlatego najpierw zbudujemy prostą wersję z użyciem redigo i ristretto.
Najpierw instalujemy dwie zależności.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // number of keys to track frequency of (10M).
22		MaxCost:     1 << 30, // maximum cost of cache (1GB).
23		BufferItems: 64,      // number of keys per Get buffer.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Najpierw w prosty sposób tworzymy RedisClient, który zawiera ristretto i redigo.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
Kod jest nieco skomplikowany.
- Aby wykonać Tracking, nawiązujemy jeszcze jedno połączenie. Zrobiono to z uwagi na to, że PubSub mógłby przeszkadzać innym operacjom.
- Pobieramy identyfikator dodatkowego połączenia i ustawiamy, aby Tracking w połączeniu, które odczytuje dane, przekierowywał się do tego połączenia.
- Następnie subskrybujemy invalidation message.
- Obsługa subskrypcji jest nieco skomplikowana. Ponieważ redigo nie parsuje wiadomości unieważniających, trzeba odebrać odpowiedź przed parsowaniem i dopiero ją przetworzyć.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
Metoda Get najpierw sprawdza ristretto w następujący sposób, a jeśli wartości tam nie ma, pobiera ją z Redisa.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
Powyższy kod służy do testów. Jeśli go uruchomisz, zobaczysz, że za każdym razem, gdy dane w Redisie zostaną zaktualizowane, wartość jest odświeżana.
Jest to jednak zbyt skomplikowane. Co więcej, aby rozszerzyć rozwiązanie na klaster, konieczne jest włączenie Tracking dla wszystkich master oraz replik.
Rueidis
Skoro piszemy w Go, dysponujemy najnowocześniejszą i najbardziej rozwiniętą biblioteką, czyli rueidis. Napiszmy kod wykorzystujący server assisted client side cache w środowisku klastra Redis z użyciem rueidis.
Najpierw instalujemy zależność.
github.com/redis/rueidis
Następnie piszemy kod, który odpytuje Redisa o dane.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
Aby użyć client side cache w rueidis, wystarczy wywołać DoCache. Następnie można dodać wynik do lokalnej pamięci podręcznej, określając, jak długo ma być w niej przechowywany, a kolejne wywołanie DoCache pobierze dane z lokalnej pamięci. Oczywiście obsługuje on także invalidation message.
Dlaczego nie redis-go?
Niestety redis-go nie obsługuje server assisted client side cache w swoim oficjalnym API. Co więcej, przy tworzeniu PubSub otwiera nowe połączenie, a brak API umożliwiającego bezpośredni dostęp do tego połączenia sprawia, że nie da się poznać client id. Dlatego uznaliśmy, że konfiguracja z użyciem redis-go jest niemożliwa i ją pominęliśmy.
Jak to seksowne
Dzięki strukturze client side cache
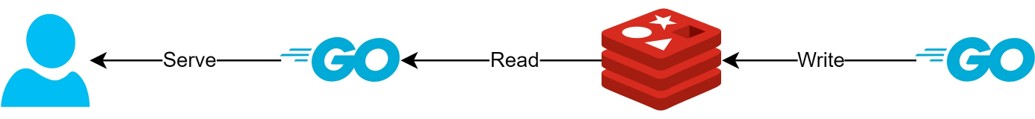
- Jeśli dane można przygotować z wyprzedzeniem, dzięki tej strukturze można zminimalizować zapytania i ruch do Redisa, a jednocześnie zawsze udostępniać aktualne dane.
- Pozwala to stworzyć rodzaj struktury CQRS, a tym samym znacząco zwiększyć wydajność odczytu.
Jak bardzo stało się to bardziej seksowne?
Faktycznie, na miejscu używamy właśnie takiej struktury, dlatego sprawdziliśmy przybliżone opóźnienia dla dwóch API. Proszę o wyrozumiałość, że mogę przedstawić je jedynie w sposób bardzo ogólny.
- Pierwsze API
- Przy pierwszym zapytaniu: średnio 14,63 ms
- Przy kolejnych zapytaniach: średnio 2,82 ms
- Średnia różnica: 10,98 ms
- Drugie API
- Przy pierwszym zapytaniu: średnio 14,05 ms
- Przy kolejnych zapytaniach: średnio 1,60 ms
- Średnia różnica: 11,57 ms
W najlepszym przypadku uzyskano dodatkową poprawę opóźnień rzędu 82%!
Spodziewamy się, że przyczyniły się do tego następujące usprawnienia.
- Pominięcie komunikacji sieciowej między klientem a Redisem oraz oszczędność ruchu
- Zmniejszenie liczby poleceń odczytu, które musi wykonać sam Redis
- Ma to również efekt w postaci zwiększenia wydajności zapisu.
- Minimalizacja parsowania protokołu Redis
- Parsowanie protokołu Redis także nie jest bezkosztowe. Ograniczenie tego jest dużą szansą.
Jednak każde rozwiązanie wiąże się z kompromisami. Dlatego musieliśmy poświęcić przynajmniej dwie rzeczy.
- Konieczność wdrożenia, utrzymania i obsługi elementów zarządzania client side cache
- Wynikający z tego wzrost zużycia procesora i pamięci po stronie klienta
Wnioski
Osobiście uważam, że był to satysfakcjonujący element architektury, a obciążenie opóźnieniami oraz serwera API było bardzo niewielkie. Chciałbym w przyszłości, o ile to możliwe, budować architekturę właśnie w ten sposób.