 GoSuda
Randflake ID: Generowanie rozproszonych 64-bitowych unikalnych identyfikatorów z wykorzystaniem szyfru blokowego Sparx64

Rozważmy sytuację, w której musimy generować unikalne 64-bitowe liczby losowe, a podmioty zewnętrzne nie powinny być w stanie przewidzieć następnej ani poprzedniej liczby.
Tutaj możemy wygenerować 8-bajtową wartość losową, sprawdzić, czy już istnieje ona w bazie danych, a następnie ją zapisać, jeśli jest unikalna.
Metoda ta ma jednak kilka wad. Musimy przechowywać każdą wygenerowaną liczbę w bazie danych, aby zapewnić unikalność. Wymóg wykonania co najmniej jednego połączenia z bazą danych (round trip) powoduje problemy z opóźnieniami, szczególnie w środowisku rozproszonym, gdzie kluczowa jest skalowalność.
Aby rozwiązać te problemy, wprowadzamy Randflake ID: rozproszony, jednostajny, nieprzewidywalny i unikalny generator identyfikatorów losowych.
Jak działa Randflake ID?
Randflake ID jest inspirowany Snowflake ID, powszechnie stosowanym mechanizmem generowania identyfikatorów typu k-sorted, opracowanym przez X (dawniej Twitter).
Snowflake ID wykorzystuje bieżący znacznik czasu, identyfikator węzła oraz lokalny licznik do wygenerowania identyfikatora.
Rozszerzyliśmy to podejście w kierunku generowania unikalnych losowych identyfikatorów i dodaliśmy nowy element: tajny klucz.
Kluczową ideą jest dodanie warstwy szyfru blokowego do istniejącego generatora unikalnych identyfikatorów, aby osiągnąć niemożliwość przewidzenia zależności między liczbami.
Szyfr blokowy jest podstawową funkcją kryptograficzną, która przekształca blok tekstu jawnego o stałej długości w blok szyfrogramu o tej samej długości. Przekształcenie to jest determinowane przez klucz kryptograficzny. Wyróżniającą cechą szyfru blokowego jest jego odwracalność: musi on być funkcją różnowartościową i na (bijekcją), zapewniając, że każde unikalne wejście odpowiada unikalnemu wyjściu i odwrotnie. Ta własność jest kluczowa dla deszyfrowania, umożliwiając odzyskanie oryginalnego tekstu jawnego z szyfrogramu przy zastosowaniu prawidłowego klucza.
Stosując szyfr blokowy jako funkcję różnowartościową, możemy zagwarantować, że każde unikalne wejście wytworzy odpowiadające mu unikalne wyjście w określonym zakresie.
Struktura i zagadnienia projektowe
Opierając się na tych podstawowych koncepcjach, przyjrzyjmy się, jak Randflake ID implementuje te idee w praktyce.
Struktura Randflake ID obejmuje 30-bitowy znacznik czasu unix z dokładnością do sekundy, 17-bitowy identyfikator węzła, 17-bitowy lokalny licznik oraz 64-bitowy szyfr blokowy oparty na algorytmie sparx64.
Oto niektóre decyzje projektowe:
Niektóre instancje maszyn wirtualnych w Google Cloud Platform mogą synchronizować zegar z dokładnością do 0,2 ms, jednak taki poziom dokładności nie jest dostępny w publicznym internecie ani u innych dostawców chmury.
Wybraliśmy dokładność do sekundy, ponieważ skutecznie synchronizujemy zegar między węzłami jedynie z rozdzielczością kilku milisekund.
17-bitowy identyfikator węzła pozwala na 131072 indywidualnych generatorów w tym samym momencie, które mogą być przypisywane w sposób per proces, per rdzeń lub per wątek.
W systemach o wysokiej przepustowości 17-bitowy lokalny licznik może okazać się niewystarczający. Aby sprostać przepustowości, możemy przypisać wiele generatorów, każdy z odrębnym identyfikatorem węzła, do pracy w jednym procesie lub wątku.
Jako 64-bitowy szyfr blokowy przyjęliśmy sparx64, nowoczesny lekki szyfr blokowy oparty na operacjach ARX.
Identyfikatory Randflake oferują wewnętrzną śledzalność, ujawniając swój węzeł źródłowy i znacznik czasu wyłącznie osobom posiadającym tajny klucz.
Teoretyczna maksymalna przepustowość wynosi 17 179 869 184 ID/s, co jest wystarczające dla większości aplikacji o zasięgu globalnym.
Pseudokod generowania Randflake ID
Aby dodatkowo zilustrować proces generowania Randflake ID, poniższy pseudokod w języku Python przedstawia uproszczoną implementację:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Stałe
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Niedziela, 27 października 2024, 3:33:20 UTC
 7
 8# Przydział bitów
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bitów na znacznik czasu (okres użytkowania 34 lata)
10RANDFLAKE_NODE_BITS = 17  # 17 bitów na identyfikator węzła (maks. 131072 węzły)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bitów na sekwencję (maks. 131072 sekwencje)
12
13# Stałe pochodne
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Produkcyjna implementacja Randflake, zawierająca mechanizm dzierżawy identyfikatorów węzłów (node ID lease), jest dostępna na GitHub.
Pozostałe zagadnienia
W tej sekcji omówimy dodatkowe zagadnienia dotyczące implementacji Randflake ID.
Koordynacja identyfikatorów węzłów
Sugerujemy koordynację identyfikatorów węzłów opartą na dzierżawach (lease-based).
W tym podejściu centralna usługa koordynacyjna przydziela każdemu generatorowi unikalny identyfikator węzła.
Identyfikator ten nie jest ponownie przydzielany w okresie dzierżawy, aby zapewnić unikalność, co ogranicza potrzebę częstej komunikacji z usługą koordynacyjną.
Generator posiadający dzierżawę może zażądać jej odnowienia od usługi koordynacyjnej, jeśli spełniony jest warunek odnowienia.
Warunek odnowienia odnosi się do zestawu kryteriów, które muszą zostać spełnione, aby dzierżawa mogła zostać odnowiona, na przykład: generator nadal jest aktywny i wymaga identyfikatora węzła.
Posiadacz dzierżawy (leaseholder) jest obecnym właścicielem zakresu identyfikatorów węzłów.
Dzierżawa uznawana jest za aktywną i niewygasłą, jeżeli mieści się w swoim ważnym okresie.
W ten sposób możemy ograniczyć liczbę połączeń (round trips) do jednego na okres odnowienia dzierżawy, minimalizując opóźnienia i zwiększając wydajność w systemach rozproszonych.
Zabezpieczenie przed wadliwym zegarem
Usługa dzierżaw musi sprawdzać spójność znaczników czasu podczas przydzielania dzierżawy. Początek przydzielonej dzierżawy musi być większy lub równy początkowi poprzedniej dzierżawy.
Generator powinien odrzucić żądanie, jeśli bieżący znacznik czasu jest mniejszy niż początek dzierżawy lub większy niż koniec dzierżawy.
Procedura ta jest istotna dla ochrony unikalności generowanych identyfikatorów w przypadku cofnięcia się zegara. Na przykład, jeśli zegar cofnie się, nowa dzierżawa może zostać przydzielona z czasem początkowym wcześniejszym niż w przypadku poprzednio przydzielonej dzierżawy, co może prowadzić do generowania duplikatów identyfikatorów. Odrzucając żądania ze znacznikami czasu mieszczącymi się w istniejącym okresie dzierżawy, zapobiegamy temu scenariuszowi i zachowujemy unikalność identyfikatorów.
Jednostajność rozkładu identyfikatorów
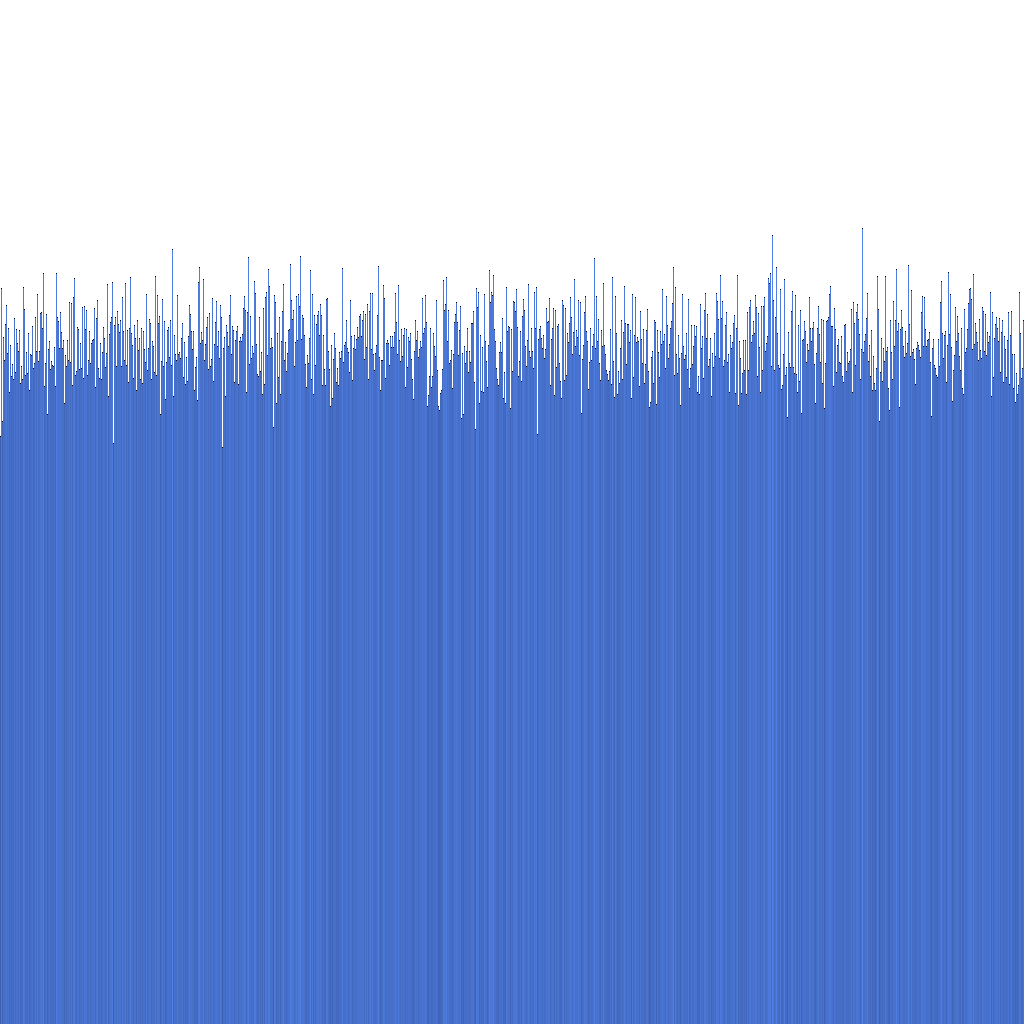
Na podstawie powyższego histogramu widzimy, że rozkład generowanych identyfikatorów Randflake jest bardzo jednostajny. Sugeruje to, że rozkład identyfikatorów może być wykorzystany bezpośrednio jako klucz shardingu.
Podsumowanie
W tym artykule przedstawiliśmy Randflake, nowatorski algorytm generowania identyfikatorów, który łączy zalety Snowflake i Sparx64.
Mamy nadzieję, że artykuł ten zapewnił Państwu kompleksowe zrozumienie Randflake oraz jego implementacji.
Pełny kod źródłowy Randflake można znaleźć na GitHub.
Jeśli masz pytania lub sugestie, proszę się nie wahać i skontaktować. Poszukujemy również współtwórców, którzy pomogą ulepszyć Randflake i zaimplementować go w innych językach programowania.
Planujemy wydać produkcyjną usługę koordynacyjną dla Randflake i Snowflake, która zostanie udostępniona na GitHub jako oprogramowanie open source. Bądźcie czujni na aktualizacje!