 GoSuda
Melhorando a responsividade com cache do lado do cliente no Redis

O que é o Redis?
Acredito que poucas pessoas desconhecem o Redis. Ainda assim, para mencionar brevemente algumas de suas características antes de prosseguir, elas podem ser resumidas da seguinte forma.
- As operações são executadas em uma thread única, de modo que todas as operações possuem atomicidade.
- Os dados são armazenados e processados In-Memory, de modo que todas as operações são rápidas.
- O Redis pode armazenar o WAL conforme as opções configuradas, permitindo realizar backup e recuperar rapidamente o estado mais recente.
- Por suportar diversos tipos de dados, como Set, Hash, Bit e List, possui alta produtividade.
- Por possuir uma grande comunidade, é possível compartilhar e receber diversas experiências, problemas e soluções.
- Por ter sido desenvolvido e operado por um longo período, possui estabilidade confiável.
Agora, ao assunto principal
Imagine?
E se o cache do seu serviço atendesse às duas condições a seguir?
- Dados consultados com frequência precisam ser fornecidos aos usuários em seu estado mais recente, mas, como as atualizações são irregulares, o cache precisa ser atualizado com frequência
- Os dados não são atualizados, mas o mesmo dado de cache é acessado e consultado com muita frequência
O primeiro caso pode ser exemplificado pelo ranking de popularidade em tempo real de um shopping online. Quando o ranking de popularidade em tempo real é armazenado como sorted set, ler no Redis sempre que um usuário acessa a página principal é ineficiente. O segundo caso se refere a dados de taxa de câmbio: mesmo que os dados sejam divulgados aproximadamente a cada 10 minutos, as consultas ocorrem com muita frequência. Em especial, para won-dólar, won-iene e won-yuan, o cache é consultado com grande frequência. Nesses casos, é mais eficiente que o servidor de API mantenha um cache local separado e, quando os dados forem alterados, consulte novamente o Redis para atualizá-lo.
Então, como implementar esse comportamento na estrutura banco de dados - Redis - servidor de API?
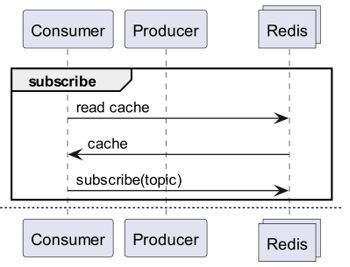
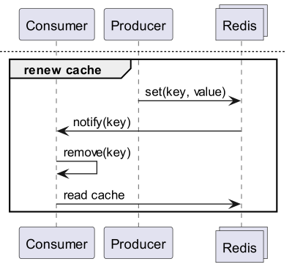
Não seria possível com o Redis PubSub?
Ao usar o cache, vamos assinar um canal que permita receber notificações de atualização!
- Nesse caso, é necessário criar uma lógica que envie uma mensagem no momento da atualização.
- Como há operações adicionais decorrentes do PubSub, o desempenho é afetado.
E se o próprio Redis detectasse as alterações?
E se usássemos Keyspace Notification para receber notificações de comandos referentes a determinada chave?
- É preciso definir previamente e compartilhar as chaves e os comandos usados nas atualizações, o que é trabalhoso.
- Por exemplo, para algumas chaves o comando de atualização é um simples Set, enquanto para outras é LPush, RPush, SAdd ou SRem, o que torna tudo mais complexo.
- Isso aumenta consideravelmente a possibilidade de falhas de comunicação durante o desenvolvimento e de erros humanos na codificação.
E se usássemos Keyevent Notification para receber notificações por comando?
- É necessário assinar todos os comandos usados nas atualizações, além de filtrar adequadamente as chaves recebidas.
- Por exemplo, entre todas as chaves recebidas por Del, algumas podem não ter cache local no respectivo cliente, o que é altamente provável.
- Isso pode levar ao desperdício desnecessário de recursos.
Por isso, o necessário é a Invalidation Message!
O que é a Invalidation Message?
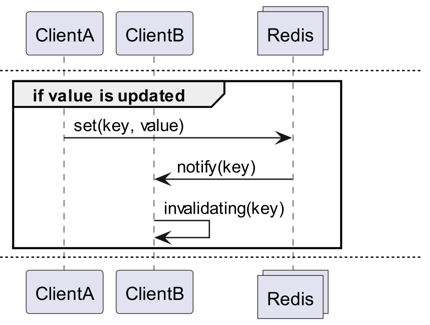
As Invalidation Messages são um conceito fornecido como parte do Server Assisted Client-Side Cache, introduzido no Redis 6.0. A Invalidation Message é entregue pelo seguinte fluxo.
- Suponha que o ClientB já tenha lido uma vez a key.
- O ClientA define novamente essa key.
- O Redis detecta a alteração e publica uma Invalidation Message para o ClientB, informando-o para limpar o cache.
- O ClientB recebe a mensagem e toma as medidas apropriadas.
Como utilizar
Estrutura básica de funcionamento
Um cliente conectado ao Redis executa CLIENT TRACKING ON REDIRECT <client-id> para receber as invalidation messages. Em seguida, o cliente que deve receber as mensagens assina SUBSCRIBE __redis__:invalidate para recebê-las.
Default tracking
1# client 1
2> SET a 100
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2> CLIENT TRACKING ON REDIRECT 12
3> GET a # tracking
1# client 1
2> SET a 200
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "a"
Broadcasting tracking
1# client 3
2> CLIENT ID
312
4> SUBSCRIBE __redis__:invalidate
51) "subscribe"
62) "__redis__:invalidate"
73) (integer) 1
1# client 2
2CLIENT TRACKING ON BCAST PREFIX cache: REDIRECT 12
1# client 1
2> SET cache:name "Alice"
3> SET cache:age 26
1# client 3
21) "message"
32) "__redis__:invalidate"
43) 1) "cache:name"
51) "message"
62) "__redis__:invalidate"
73) 1) "cache:age"
Implementação! Implementação! Implementação!
Redigo + Ristretto
Explicar apenas dessa forma torna difícil saber como usar isso de fato no código. Por isso, vamos primeiro montar uma estrutura simples com redigo e ristretto.
Primeiro, instale as duas dependências.
github.com/gomodule/redigogithub.com/dgraph-io/ristretto
 1package main
 2
 3import (
 4	"context"
 5	"fmt"
 6	"log/slog"
 7	"time"
 8
 9	"github.com/dgraph-io/ristretto"
10	"github.com/gomodule/redigo/redis"
11)
12
13type RedisClient struct {
14	conn  redis.Conn
15	cache *ristretto.Cache[string, any]
16	addr  string
17}
18
19func NewRedisClient(addr string) (*RedisClient, error) {
20	cache, err := ristretto.NewCache(&ristretto.Config[string, any]{
21		NumCounters: 1e7,     // número de chaves para rastrear a frequência (10M).
22		MaxCost:     1 << 30, // custo máximo do cache (1GB).
23		BufferItems: 64,      // número de chaves por buffer de Get.
24	})
25	if err != nil {
26		return nil, fmt.Errorf("failed to generate cache: %w", err)
27	}
28
29	conn, err := redis.Dial("tcp", addr)
30	if err != nil {
31		return nil, fmt.Errorf("failed to connect to redis: %w", err)
32	}
33
34	return &RedisClient{
35		conn:  conn,
36		cache: cache,
37		addr:  addr,
38	}, nil
39}
40
41func (r *RedisClient) Close() error {
42	err := r.conn.Close()
43	if err != nil {
44		return fmt.Errorf("failed to close redis connection: %w", err)
45	}
46
47	return nil
48}
Primeiro, criamos de forma simples um RedisClient que contém ristretto e redigo.
 1func (r *RedisClient) Tracking(ctx context.Context) error {
 2	psc, err := redis.Dial("tcp", r.addr)
 3	if err != nil {
 4		return fmt.Errorf("failed to connect to redis: %w", err)
 5	}
 6
 7	clientId, err := redis.Int64(psc.Do("CLIENT", "ID"))
 8	if err != nil {
 9		return fmt.Errorf("failed to get client id: %w", err)
10	}
11	slog.Info("client id", "id", clientId)
12
13	subscriptionResult, err := redis.String(r.conn.Do("CLIENT", "TRACKING", "ON", "REDIRECT", clientId))
14	if err != nil {
15		return fmt.Errorf("failed to enable tracking: %w", err)
16	}
17	slog.Info("subscription result", "result", subscriptionResult)
18
19	if err := psc.Send("SUBSCRIBE", "__redis__:invalidate"); err != nil {
20		return fmt.Errorf("failed to subscribe: %w", err)
21	}
22	psc.Flush()
23
24	for {
25		msg, err := psc.Receive()
26		if err != nil {
27			return fmt.Errorf("failed to receive message: %w", err)
28		}
29
30		switch msg := msg.(type) {
31		case redis.Message:
32			slog.Info("received message", "channel", msg.Channel, "data", msg.Data)
33			key := string(msg.Data)
34			r.cache.Del(key)
35		case redis.Subscription:
36			slog.Info("subscription", "kind", msg.Kind, "channel", msg.Channel, "count", msg.Count)
37		case error:
38			return fmt.Errorf("error: %w", msg)
39		case []interface{}:
40			if len(msg) != 3 || string(msg[0].([]byte)) != "message" || string(msg[1].([]byte)) != "__redis__:invalidate" {
41				slog.Warn("unexpected message", "message", msg)
42				continue
43			}
44
45			contents := msg[2].([]interface{})
46			keys := make([]string, len(contents))
47			for i, key := range contents {
48				keys[i] = string(key.([]byte))
49				r.cache.Del(keys[i])
50			}
51			slog.Info("received invalidation message", "keys", keys)
52		default:
53			slog.Warn("unexpected message", "type", fmt.Sprintf("%T", msg))
54		}
55	}
56}
O código está um pouco complexo.
- Para realizar o Tracking, abrimos mais uma conexão. Isso foi feito considerando que o PubSub poderia interferir em outras operações.
- Consultamos o ID da conexão adicionada e configuramos o Tracking da conexão que consulta os dados para redirecionar para essa conexão.
- Em seguida, assinamos a invalidation message.
- O código que processa a assinatura é um pouco complexo. Como o redigo não faz o parsing das invalidation messages, é preciso receber a resposta antes do parsing e tratá-la.
 1func (r *RedisClient) Get(key string) (any, error) {
 2	val, found := r.cache.Get(key)
 3	if found {
 4		switch v := val.(type) {
 5		case int64:
 6			slog.Info("cache hit", "key", key)
 7			return v, nil
 8		default:
 9			slog.Warn("unexpected type", "type", fmt.Sprintf("%T", v))
10		}
11	}
12	slog.Info("cache miss", "key", key)
13
14	val, err := redis.Int64(r.conn.Do("GET", key))
15	if err != nil {
16		return nil, fmt.Errorf("failed to get key: %w", err)
17	}
18
19	r.cache.SetWithTTL(key, val, 1, 10*time.Second)
20	return val, nil
21}
O método Get primeiro consulta o ristretto e, caso não encontre o valor, o obtém do Redis, conforme o código abaixo.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9)
10
11func main() {
12	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
13	defer cancel()
14
15	client, err := NewRedisClient("localhost:6379")
16	if err != nil {
17		panic(err)
18	}
19	defer client.Close()
20
21	go func() {
22		if err := client.Tracking(ctx); err != nil {
23			slog.Error("failed to track invalidation message", "error", err)
24		}
25	}()
26
27	ticker := time.NewTicker(1 * time.Second)
28	defer ticker.Stop()
29	done := ctx.Done()
30
31	for {
32		select {
33		case <-done:
34			slog.Info("shutting down")
35			return
36		case <-ticker.C:
37			v, err := client.Get("key")
38			if err != nil {
39				slog.Error("failed to get key", "error", err)
40				return
41			}
42			slog.Info("got key", "value", v)
43		}
44	}
45}
O código para teste é o acima. Se você testar, poderá verificar que o valor é atualizado sempre que os dados são alterados no Redis.
No entanto, isso é muito complexo. Acima de tudo, para escalar em um cluster, é inevitável habilitar o Tracking em todos os masters ou réplicas.
Rueidis
Já que usamos Go, temos à disposição o rueidis, a opção mais moderna e avançada. Vamos escrever um código que utiliza o server assisted client side cache em um ambiente de cluster Redis com o rueidis.
Primeiro, instale a dependência.
github.com/redis/rueidis
Em seguida, escrevemos o código que consulta os dados no Redis.
 1package main
 2
 3import (
 4	"context"
 5	"log/slog"
 6	"os"
 7	"os/signal"
 8	"time"
 9
10	"github.com/redis/rueidis"
11)
12
13func main() {
14	ctx, cancel := signal.NotifyContext(context.Background(), os.Interrupt)
15	defer cancel()
16
17	client, err := rueidis.NewClient(rueidis.ClientOption{
18		InitAddress: []string{"localhost:6379"},
19	})
20	if err != nil {
21		panic(err)
22	}
23
24	ticker := time.NewTicker(1 * time.Second)
25	defer ticker.Stop()
26	done := ctx.Done()
27
28	for {
29		select {
30		case <-done:
31			slog.Info("shutting down")
32			return
33		case <-ticker.C:
34			const key = "key"
35			resp := client.DoCache(ctx, client.B().Get().Key(key).Cache(), 10*time.Second)
36			if resp.Error() != nil {
37				slog.Error("failed to get key", "error", resp.Error())
38				continue
39			}
40			i, err := resp.AsInt64()
41			if err != nil {
42				slog.Error("failed to convert response to int64", "error", err)
43				continue
44			}
45			switch resp.IsCacheHit() {
46			case true:
47				slog.Info("cache hit", "key", key)
48			case false:
49				slog.Info("missed key", "key", key)
50			}
51			slog.Info("got key", "value", i)
52		}
53	}
54}
No rueidis, para usar o client side cache basta chamar DoCache. Assim, como ao adicionar ao cache local, é possível definir por quanto tempo os dados serão mantidos localmente, e ao chamar DoCache novamente, os dados são consultados e obtidos do cache local. Naturalmente, as invalidation messages também são tratadas corretamente.
Por que não redis-go?
Infelizmente, o redis-go não oferece suporte oficial ao server assisted client side cache. Além disso, ao criar um PubSub, ele abre uma nova conexão sem fornecer uma API para acessá-la diretamente, de modo que não é possível obter o client id. Por isso, consideramos que a configuração do redis-go seria inviável e o descartamos.
Que elegante
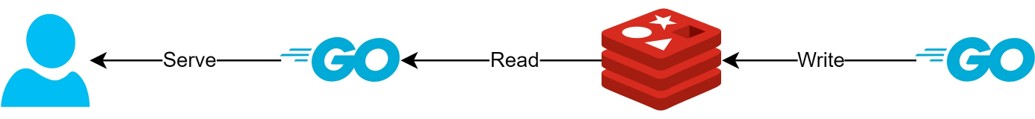
Por meio da estrutura de client side cache
- Para dados que podem ser preparados antecipadamente, essa estrutura permite minimizar consultas e tráfego para o Redis, mantendo sempre os dados mais recentes.
- Com isso, é possível criar uma espécie de estrutura CQRS e aumentar drasticamente o desempenho de leitura.
Quanto mais elegante ficou?
Como, por coincidência, estamos usando essa estrutura em produção, medimos a latência aproximada de duas APIs. Peço desculpas por apresentar apenas dados muito abstratos.
- Primeira API
- Na primeira consulta: média de 14,63 ms
- Nas consultas seguintes: média de 2,82 ms
- Diferença média: 10,98 ms
- Segunda API
- Na primeira consulta: média de 14,05 ms
- Nas consultas seguintes: média de 1,60 ms
- Diferença média: 11,57 ms
Houve uma melhoria adicional de latência de até cerca de 82%!
Esperamos que tenham ocorrido as seguintes melhorias:
- Eliminação da comunicação de rede entre o cliente e o Redis e economia de tráfego
- Redução do número de comandos de leitura que o próprio Redis precisa executar
- Isso também tem o efeito de melhorar o desempenho de escrita.
- Redução do parsing do protocolo Redis
- O parsing do protocolo Redis também não tem custo zero. Poder reduzi-lo é uma grande oportunidade.
No entanto, toda decisão envolve trade-offs. Para isso, sacrificamos pelo menos os dois pontos a seguir.
- Necessidade de implementar, operar e manter os componentes de gerenciamento do client side cache
- Aumento do uso de CPU e memória no cliente decorrente disso
Conclusão
Pessoalmente, foi um componente de arquitetura satisfatório, e a latência e a pressão sobre o servidor de API também foram bastante baixas. Penso em continuar estruturando a arquitetura dessa forma sempre que possível.