 GoSuda
Randflake ID: Geração Distribuída de Identificadores Únicos de 64 Bits com a Cifra de Bloco Sparx64

Considere uma situação em que precisamos gerar números aleatórios únicos de 64 bits, e as partes externas não devem conseguir prever o próximo ou o número anterior.
Aqui, podemos gerar um valor aleatório de 8 bytes, verificar se ele já existe no banco de dados e, em seguida, armazená-lo caso seja único.
No entanto, este método apresenta várias desvantagens. Precisamos armazenar todo número gerado em um banco de dados para garantir a unicidade. A exigência de pelo menos uma ida e volta ao banco de dados cria problemas de latência, particularmente em um ambiente distribuído, onde a escalabilidade é crucial.
Para resolver esses problemas, estamos apresentando o Randflake ID: um gerador de IDs aleatórios distribuído, uniforme, imprevisível e único.
Como Funciona o Randflake ID?
O Randflake ID é inspirado no Snowflake ID, o mecanismo de geração de identificadores k-ordenáveis amplamente utilizado, desenvolvido pela X (anteriormente Twitter).
O Snowflake ID utiliza o timestamp atual, um ID de nó e um contador local para gerar um identificador.
Expandimos ainda mais essa abordagem para a geração de IDs aleatórios únicos e acrescentamos um novo elemento: uma chave secreta.
A ideia central é adicionar uma camada de cifra de bloco ao gerador de IDs únicos existente, para alcançar a inviabilidade de prever a relação entre os números.
Uma cifra de bloco é uma função criptográfica fundamental que transforma um bloco de texto simples de tamanho fixo em um bloco de texto cifrado de mesmo tamanho. Essa transformação é governada por uma chave criptográfica. A característica distintiva de uma cifra de bloco é a sua reversibilidade: ela deve ser uma função biunívoca (bijetiva), garantindo que cada entrada única corresponda a uma saída única, e vice-versa. Essa propriedade é crucial para a decifragem, permitindo que o texto simples original seja recuperado a partir do texto cifrado quando a chave correta é aplicada.
Ao empregar uma cifra de bloco como uma função biunívoca, podemos garantir que cada entrada única produza uma saída única correspondente dentro do intervalo definido.
A estrutura e as considerações de projeto
Com base nesses conceitos fundamentais, vamos examinar como o Randflake ID implementa essas ideias na prática.
A estrutura do Randflake ID inclui um timestamp Unix de 30 bits com precisão de segundos, um identificador de nó de 17 bits, um contador local de 17 bits e uma cifra de bloco de 64 bits baseada no algoritmo sparx64.
Seguem algumas decisões de projeto:
Algumas instâncias de VM no Google Cloud Platform conseguem sincronizar o relógio com precisão de 0,2 ms, mas esse nível de precisão não está disponível na internet pública ou em outros provedores de nuvem.
Escolhemos a precisão de segundos porque só conseguimos sincronizar o relógio entre os nós de forma eficaz com resoluções de alguns milissegundos.
O identificador de nó de 17 bits permite 131.072 geradores individuais no mesmo momento, que podem ser atribuídos por processo, por núcleo ou por thread.
Em sistemas de alta vazão, o contador local de 17 bits pode ser insuficiente. Para acompanhar a vazão, podemos atribuir múltiplos geradores, cada um com um ID de nó distinto, para operar em um único processo ou thread.
Adotamos o sparx64 como cifra de bloco de 64 bits, uma cifra de bloco moderna e leve baseada em operações ARX.
Os IDs do Randflake oferecem rastreabilidade interna, revelando seu ID de nó de origem e timestamp apenas para quem possui a chave secreta.
A vazão máxima teórica é de 17.179.869.184 IDs/s, o que é suficiente para a maioria das aplicações em escala global.
Pseudocódigo da geração de Randflake ID
Para ilustrar melhor o processo de geração do Randflake ID, o seguinte pseudocódigo em Python fornece uma implementação simplificada:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Constantes
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Domingo, 27 de outubro de 2024, 3:33:20 AM UTC
 7
 8# Alocação de bits
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bits para o timestamp (vida útil de 34 anos)
10RANDFLAKE_NODE_BITS = 17  # 17 bits para o ID do nó (máximo de 131072 nós)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bits para a sequência (máximo de 131072 sequências)
12
13# Constantes derivadas
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
Uma implementação pronta para produção do Randflake, que inclui um mecanismo de concessão (lease) de ID de nó, está disponível no GitHub.
Outras considerações
Nesta seção, discutiremos algumas considerações adicionais para a implementação do Randflake ID.
Coordenação de IDs de nó
Sugerimos a coordenação de IDs de nó baseada em concessões (leases).
Nessa abordagem, um serviço central de coordenação atribui um ID de nó exclusivo a cada gerador.
Este ID de nó não é reatribuído durante o período da concessão, para garantir a unicidade, o que reduz a necessidade de comunicação frequente com o serviço de coordenação.
O gerador que detém a concessão pode solicitar a renovação da concessão ao serviço de coordenação caso a condição de renovação seja atendida.
A condição de renovação refere-se a um conjunto de critérios que devem ser satisfeitos para que a concessão seja renovada, como o gerador continuar ativo e precisar do ID de nó.
O detentor da concessão é o titular atual do intervalo de IDs de nó.
A concessão é considerada ativa e não expirada enquanto estiver dentro do seu período de validade.
Dessa forma, podemos reduzir as idas e voltas ao serviço para uma por período de renovação da concessão, minimizando a latência e melhorando a eficiência em sistemas distribuídos.
Mitigação contra relógio defeituoso
O serviço de concessões deve verificar a consistência dos timestamps ao alocar uma concessão. O horário de início da concessão atribuída deve ser maior ou igual ao horário de início da última concessão.
O gerador deve rejeitar a solicitação se o timestamp atual for menor que o horário de início da concessão ou maior que o horário de término da concessão.
Esse procedimento é importante para proteger a unicidade dos IDs gerados quando o relógio retrocede. Por exemplo, se o relógio retroceder, uma nova concessão poderia ser atribuída com um horário de início anterior ao de uma concessão já atribuída, o que poderia levar à geração de IDs duplicados. Ao rejeitar solicitações cujos timestamps estejam dentro de um período de concessão existente, evitamos esse cenário e mantemos a unicidade dos IDs.
Uniformidade da distribuição de IDs
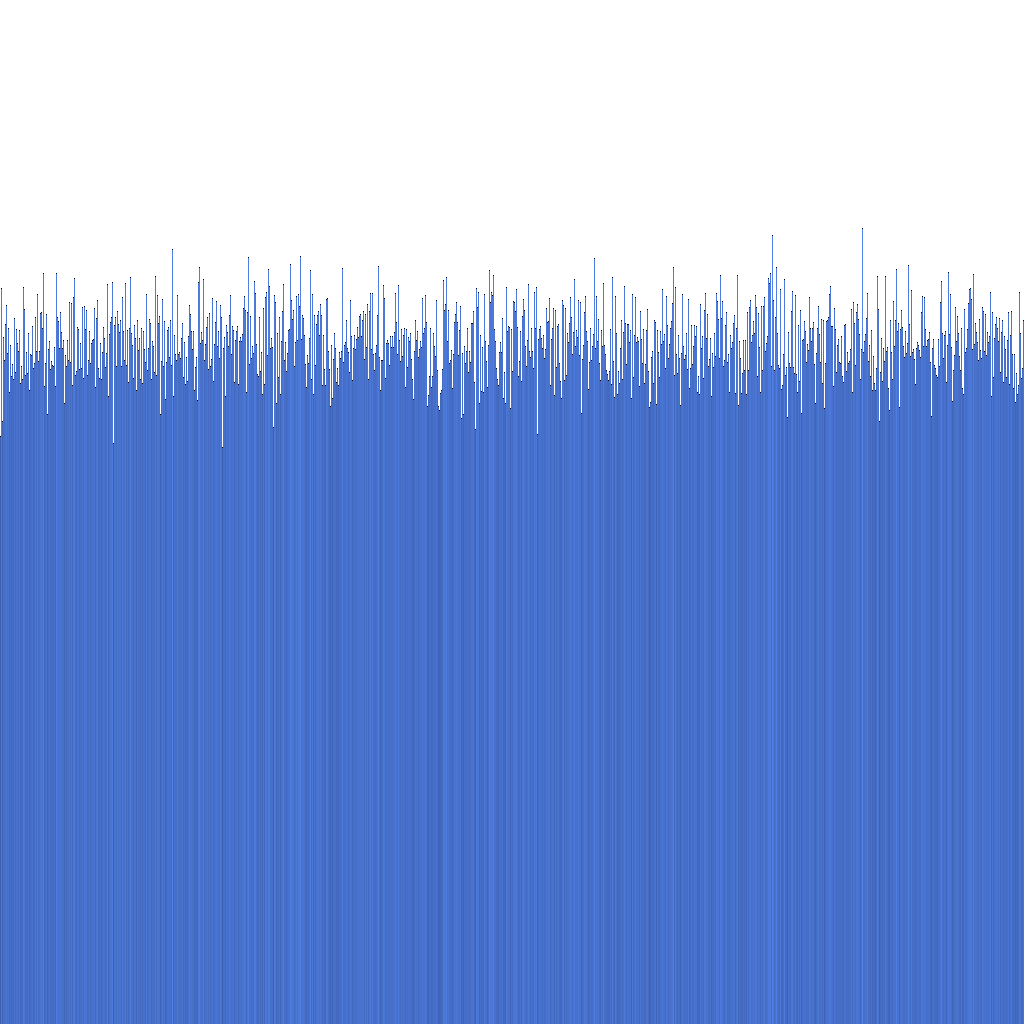
Com base no histograma acima, podemos observar que a distribuição dos IDs Randflake gerados é muito uniforme. Isso sugere que a distribuição dos IDs pode ser usada diretamente como chave de particionamento (sharding).
Conclusão
Neste artigo, apresentamos o Randflake, um novo algoritmo de geração de IDs que combina as vantagens do Snowflake e do Sparx64.
Esperamos que este artigo tenha proporcionado uma compreensão abrangente do Randflake e de sua implementação.
Você pode encontrar o código-fonte completo do Randflake no GitHub.
Se tiver dúvidas ou sugestões, não hesite em entrar em contato. Também estamos procurando colaboradores para ajudar a aprimorar o Randflake e implementá-lo em outras linguagens de programação.
Planejamos lançar um serviço de coordenação pronto para produção para o Randflake e o Snowflake, que será disponibilizado como código aberto no GitHub. Fique atento às atualizações!