 GoSuda
Randflake ID: Distribuerad generering av 64-bitars unika ID:n med blockchiffret Sparx64

Överväg en situation där vi behöver generera unika 64-bitars slumptal, och externa parter ska inte kunna förutsäga nästa eller föregående tal.
Här kan vi generera ett slumpmässigt värde på 8 byte, kontrollera om det redan finns i databasen och sedan lagra det om det är unikt.
Denna metod har dock flera nackdelar. Vi måste lagra varje genererat tal i en databas för att säkerställa unikhet. Kravet på minst en förfrågan till databasen och tillbaka skapar latensproblem, särskilt i en distribuerad miljö där skalbarhet är avgörande.
För att lösa dessa problem introducerar vi Randflake ID: en distribuerad, likformig, oförutsägbar och unik generator för slumpmässiga ID:n.
Hur fungerar Randflake ID?
Randflake ID är inspirerat av Snowflake ID, den allmänt använda k-sorterade ID-genereringsmekanismen utvecklad av X (tidigare Twitter).
Snowflake ID använder den aktuella tidsstämpeln, ett nod-ID och en lokal räknare för att generera en identifierare.
Vi utökade detta tillvägagångssätt ytterligare för generering av slumpmässiga unika ID:n och lade till ett nytt element i form av en hemlig nyckel.
Den centrala idén är att lägga till ett lager av blockchiffer ovanpå den befintliga generatorn för unika ID:n för att uppnå omöjlighet att förutsäga sambandet mellan tal.
Ett blockchiffer är en grundläggande kryptografisk funktion som transformerar ett block av klartext med fast längd till ett chiffertextblock av samma längd. Denna transformation styrs av en kryptografisk nyckel. Blockchiffrets särskilda egenskap är dess reversibilitet: det måste vara en envägs-till-envägs-funktion (bijektiv), vilket säkerställer att varje unik indata motsvarar en unik utdata, och vice versa. Denna egenskap är avgörande för dekryptering, eftersom den ursprungliga klartexten kan återställas från chiffertexten när rätt nyckel används.
Genom att använda ett blockchiffer som en envägs-till-envägs-funktion kan vi garantera att varje unik indata ger en motsvarande unik utdata inom det definierade intervallet.
Strukturen och designöverväganden
Utifrån dessa grundläggande begrepp, låt oss undersöka hur Randflake ID implementerar dessa idéer i praktiken.
Randflake ID-strukturen omfattar en 30-bitars Unix-tidsstämpel med sekundprecision, ett 17-bitars nodidentifierare, en 17-bitars lokal räknare och ett 64-bitars blockchiffer baserat på algoritmen sparx64.
Här är några designbeslut:
Vissa VM-instanser i Google Cloud Platform kan synkronisera klockan med en precision på 0,2 ms, men denna noggrannhetsnivå är inte tillgänglig på det publika internet eller hos andra molnleverantörer.
Vi valde sekundprecision eftersom vi endast effektivt kan synkronisera klockan mellan noder inom en upplösning på några millisekunder.
Ett 17-bitars nodidentifierare tillåter 131072 individuella generatorer vid samma ögonblick, vilka kan tilldelas på per-process-, per-kärna- eller per-tråd-basis.
I system med hög genomströmning kan en 17-bitars lokal räknare vara otillräcklig. För att matcha genomströmningen kan vi tilldela flera generatorer, var och en med ett distinkt nod-ID, att arbeta i en och samma process eller tråd.
Vi antog sparx64 som 64-bitars blockchiffer, ett modernt lättviktigt blockchiffer baserat på ARX-konstruktionen.
Randflake ID:n erbjuder intern spårbarhet och avslöjar sitt ursprungliga nod-ID och tidsstämpel endast för dem som innehar den hemliga nyckeln.
Den teoretiska maximala genomströmningen är 17 179 869 184 ID/s, vilket är tillräckligt för de flesta applikationer i global skala.
Pseudokod för Randflake ID-generering
För att ytterligare illustrera processen för generering av Randflake ID:n tillhandahåller följande Python-pseudokod en förenklad implementation:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# Konstanter
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # Söndag 27 oktober 2024 kl. 03:33:20 UTC
 7
 8# Bitallokering
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 30 bitar för tidsstämpel (livslängd på 34 år)
10RANDFLAKE_NODE_BITS = 17  # 17 bitar för nod-ID (max 131072 noder)
11RANDFLAKE_SEQUENCE_BITS = 17  # 17 bitar för sekvens (max 131072 sekvenser)
12
13# Härledda konstanter
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
En produktionsklar implementation av Randflake, med en mekanism för leasing av nod-ID, finns tillgänglig på GitHub.
Andra överväganden
I detta avsnitt diskuterar vi några ytterligare överväganden för implementeringen av Randflake ID.
Samordning av nod-ID
Vi föreslår en leasingbaserad samordning av nod-ID.
I detta tillvägagångssätt tilldelar en central samordningstjänst ett unikt nod-ID till varje generator.
Detta nod-ID tilldelas inte om under leasingperioden för att säkerställa unikhet, vilket minskar behovet av frekventa förfrågningar till samordningstjänsten.
Generatorn som innehar leasingen kan begära förnyelse av leasingen från samordningstjänsten om förnyelsevillkoret är uppfyllt.
Förnyelsevillkoret avser en uppsättning kriterier som måste vara uppfyllda för att leasingen ska kunna förnyas, till exempel att generatorn fortfarande är aktiv och behöver nod-ID:t.
Leasinginnehavaren är den nuvarande innehavaren av nod-ID-intervallet.
Leasingen anses vara aktiv och inte förfallen om den befinner sig inom sin giltiga tidsperiod.
På detta sätt kan vi reducera förfrågningarna till en per leasingförnyelseperiod, vilket minimerar latens och förbättrar effektiviteten i distribuerade system.
Skydd mot felaktig klocka
Leasingtjänsten måste kontrollera tidsstämpelkonsistens när en leasing tilldelas. Leasingens starttid måste vara större än eller lika med den senaste leasingens starttid.
Generatorn ska avvisa begäran om den aktuella tidsstämpeln är mindre än leasingens starttid eller större än leasingens sluttid.
Denna procedur är viktig för att skydda unikheten hos genererade ID:n när klockan hoppar bakåt. Om en klocka exempelvis hoppar bakåt kan en ny leasing tilldelas med en starttid som är tidigare än en tidigare tilldelad leasing, vilket potentiellt kan leda till dubbletter av ID:n. Genom att avvisa förfrågningar med tidsstämplar inom en befintlig leasingperiod förhindrar vi detta scenario och upprätthåller unikheten hos ID:n.
Likformighet i ID-fördelningen
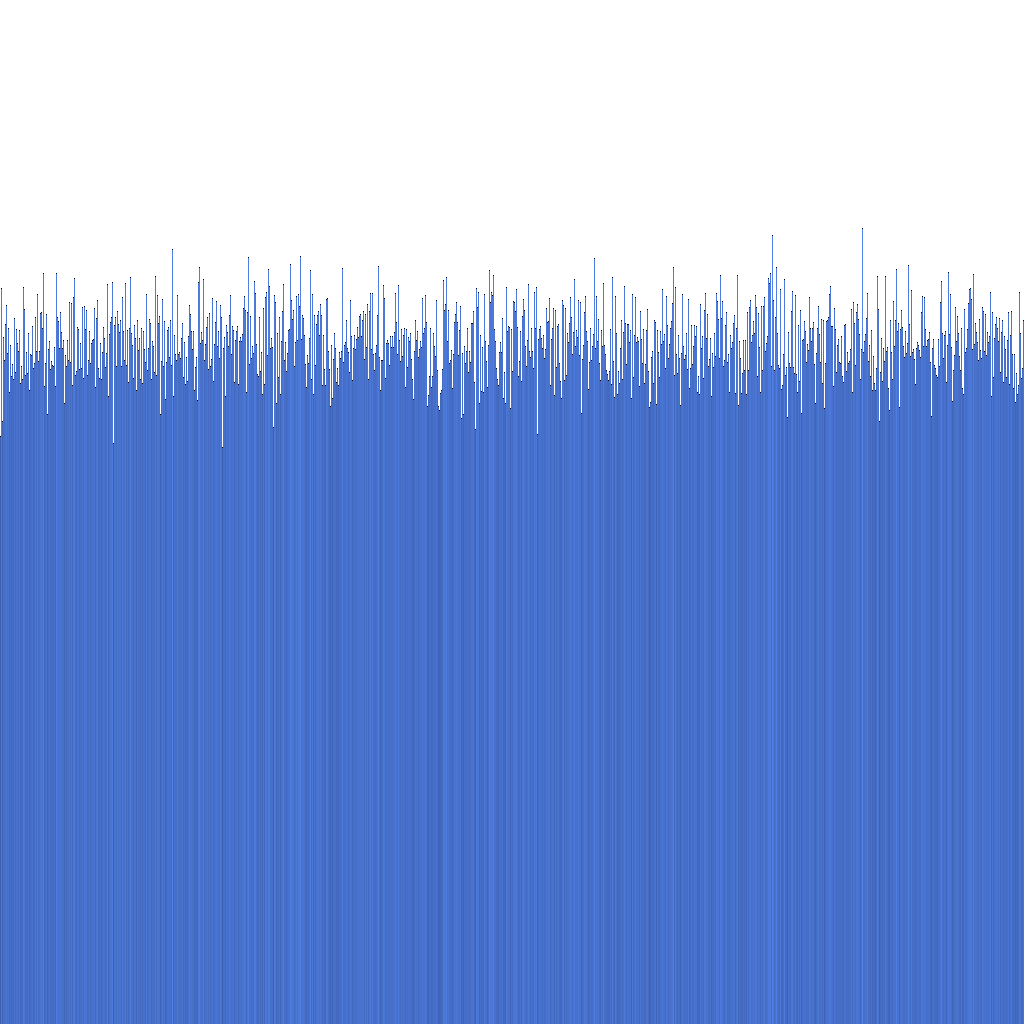
Baserat på histogrammet ovan kan vi se att fördelningen av genererade Randflake ID:n är mycket likformig. Detta tyder på att ID-fördelningen kan användas direkt som en shardningsnyckel.
Slutsats
I den här artikeln introducerade vi Randflake, en ny ID-genereringsalgoritm som kombinerar fördelarna med Snowflake och Sparx64.
Vi hoppas att den här artikeln har gett dig en omfattande förståelse för Randflake och dess implementering.
Du kan hitta den fullständiga källkoden för Randflake på GitHub.
Om du har några frågor eller förslag får du gärna kontakta oss. Vi söker också bidragsgivare som kan hjälpa till att förbättra Randflake och implementera det i andra programmeringsspråk.
Vi planerar att släppa en produktionsklar samordningstjänst för Randflake och Snowflake, som kommer att göras öppen källkod på GitHub. Håll utkik efter uppdateringar!