 GoSuda
Go 1.27,或我如何学会不再担忧并爱上泛型方法
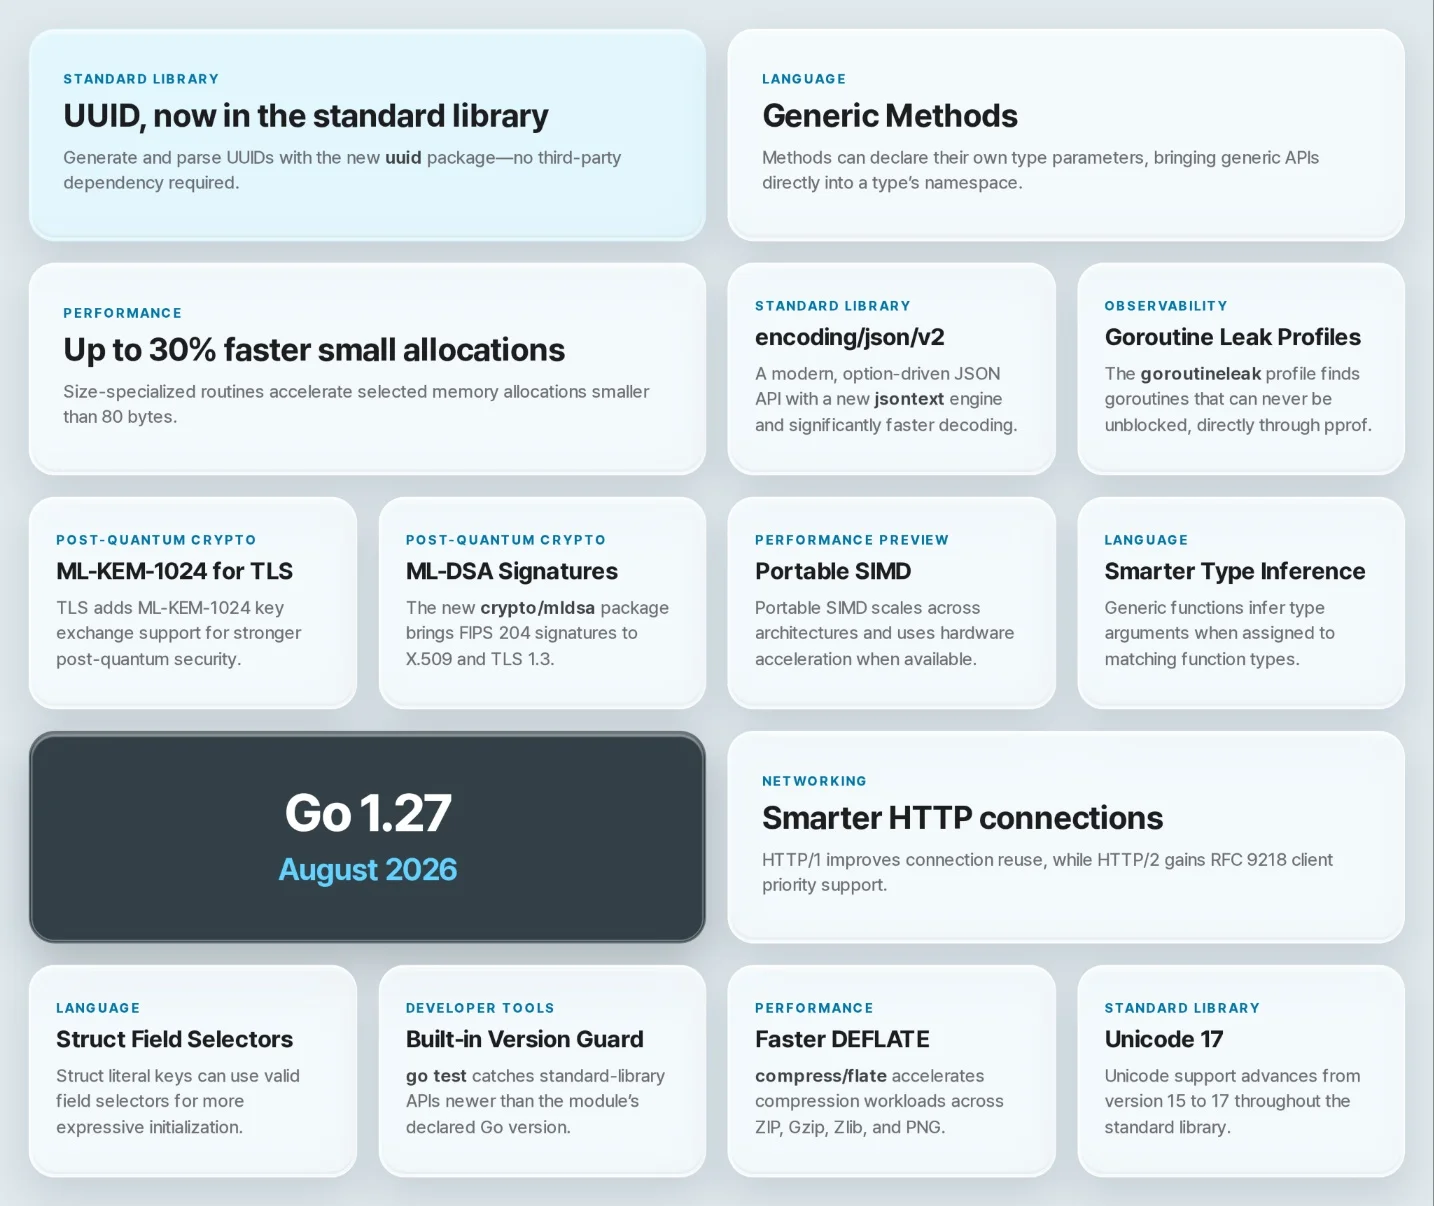
Go 1.27 将于 2026 年 8 月发布,而这一次,语言本身终于发生了变化。不是"我们给 slices 增加了一个新函数"那种变化,而是真正的变化。泛型方法正式加入。一个存在了十一年的 issue 终于关闭。encoding/json 在飞行途中被悄然替换为一套全新的引擎。
下面每一个示例都是在 go1.27rc3(darwin/arm64)上运行的。每一个输出块都是真实输出,原样复制粘贴,包括错误信息。如果某些内容看起来很奇怪,那是因为编译器确实就是这样输出的。
1go install golang.org/dl/go1.27rc3@latest
2go1.27rc3 download
1. 语言发生了变化(是的,真的)
1.1. 泛型方法
自 Go 1.18 起我们就有了泛型,而自 Go 1.18 起我们也有了这样一段对话。它大致是这样的:
"让我在我的 slice 类型上写一个
Map方法——"
method must have no type parameters"……好吧。那就用包级函数吧。"
方法只能使用由_接收者_声明的类型参数,自己的方法无法引入新的类型参数。于是每一种泛型变换都被流放到包作用域中,和另外十七个名字各异、漂浮无依的辅助函数(大多是某种 MapSlice 的变体)挤在一起。
Go 1.27 修复了这个问题:
 1type List[E any] []E
 2
 3// F 是由方法本身声明的类型参数
 4func (l List[E]) Apply[F any](f func(E) F) List[F] {
 5	r := make(List[F], len(l))
 6	for i, x := range l {
 7		r[i] = f(x)
 8	}
 9	return r
10}
11
12func main() {
13	l := List[int]{1, 2, 3}
14	fmt.Println(l.Apply(func(i int) string { return fmt.Sprint(i * 10) }))
15	// [10 20 30]
16}
接收者甚至不需要是泛型的。一个普通的结构体也可以拥有泛型方法:
1type Bag struct{ items []any }
2
3func (b *Bag) Add[T any](v T) { b.items = append(b.items, v) }
不过,在你今天下午就重构整个代码库之前,需要注意两条限制,它们的重要性超出表面所见:
- 接口方法不能声明类型参数。
- 泛型方法不能实现接口方法。
第二条是最容易让你栽跟头的:
1type Adder interface{ Add(int) int }
2
3type G struct{}
4
5func (G) Add[T any](v T) T { return v }
6
7var _ Adder = G{}
1cannot use G{} (value of struct type G) as Adder value in variable declaration:
2	G does not implement Adder (wrong type for method Add)
3		have Add[T any](T) T
4		want Add(int) int
因此,泛型方法与动态分派并不兼容。这并不是 Go 团队的吝啬,而是因为泛型方法有无穷多个实例化,而接口方法表必须是有限的且在编译期已知。你不能把一个无限的东西放进有限的表里。宇宙也不允许。
实用的结论是:泛型方法适用于具体类型上那些形如工具函数的 API。任何需要隐藏在接口之后的东西,仍然需要沿用旧的做法。
标准库已经率先利用了这一点。math/rand/v2 的 Rand 获得了一个泛型方法:
1func (r *Rand) N[Int intType](n Int) Int
1r := rand.New(rand.NewPCG(1, 2))
2fmt.Println(r.N(int32(100)))     // 76
3fmt.Println(r.N(time.Second))    // 616.436223ms
此前只有包级的 rand.N 是泛型的,这意味着只能使用全局源。现在你自己带种子的 *Rand 也获得了同样的便利。一个小改动,但很好。
1.2. 结构体字面量字段选择器,或:Issue #9859 终于得以解决
嵌入让你可以写 u.ID。但嵌入_并不能_让你写 User{ID: 1}。相反,它要求你写 User{Base: Base{ID: 1}},这是 Go 在询问你是否真的想这样做。
Issue #9859 创建于 2015 年,现已关闭。某个如今已换过两次职业的 gopher 大概正在收到一条 GitHub 通知。
 1type Object struct{ name, color string }
 2type Point3D struct {
 3	Object
 4	x, y, z float64
 5}
 6type Line struct {
 7	Object
 8	p, q Point3D
 9}
10
11// Go 1.27:直接使用提升后的字段
12line := Line{name: "diagonal", q: Point3D{y: -4, z: 12.3}}
name 并不是 Line 的字段,而是嵌入的 Object 的字段。此前你需要写 Line{Object: Object{name: "diagonal"}, ...}。
现在来看一下细则,这些内容是我通过实际尝试编译全部代码后确认的。
(a)键仍然必须是普通标识符。 你不能写任意的选择器路径。
1_ = Line{Object.name: "x"}   // invalid field name Object.name in struct literal
2_ = Line{p.x: 1}             // invalid field name p.x in struct literal
因此,这个特性的含义并不是"键现在可以像字段访问一样工作",而是特指"允许隐式提升的字段名"。它比标题所暗示的范围要窄一些。
(b)你不能同时指定一个嵌入字段以及从它提升出来的某个字段。
1obj := Object{"edge", "black"}
2_ = Line{Object: obj, name: "diagonal"}
3// cannot specify promoted field name and enclosing embedded field Object
这很合理。你对同一块内存给出了两个相互冲突的指令,编译器拒绝猜测。
(c)不鼓励使用指针嵌入。
1type PtrEmbed struct {
2	*Object
3	z int
4}
5
6_ = PtrEmbed{name: "x"}
7// invalid implicit pointer indirection to reach name
要跟随一个指针,你得先有一个指针可以跟随,而在字面量构造时还没有这样的指针。这同样合理。
好消息是:go fix 会为你自动改写旧的字面量。稍后会详细介绍。
1.3. 函数类型推断变得不那么随意
泛型函数的类型推断过去在某些位置可用、在另一些位置不可用,而且其背后看不出任何明确的原则。赋值给变量?可以。把完全相同的函数放进结构体字段?编译器报错,请像 2022 年那样写 double[int]。
Go 1.27 让推断在目标类型明确已知的每一个上下文中都能工作:
 1func double[T ~int | ~float64](v T) T { return v * 2 }
 2
 3type S struct{ f func(int) int }
 4type A [1]func(int) int
 5
 6func main() {
 7	s := S{f: double}          // 1.26:需要写 double[int]
 8	a := A{double}             // 1.26:需要写 double[int]
 9
10	c := make(chan func(int) int, 1)
11	c <- double                // 1.26:需要写 double[int]
12
13	var fn func(float64) float64 = double  // 这一写法一直可以工作
14
15	fmt.Println(s.f(21), a[0](5), (<-c)(7), fn(1.5))
16	// 42 10 14 3
17}
同一个 double,在三处被实例化为 func(int) int,在第四处被实例化为 func(float64) float64,全部由上下文完成推断。如果你编写了大量包含函数值的选项结构体或处理器表,代码库中那些烦人的 [T] 样板就要消失了。
2. 运行时:免费的性能与泄漏检测器
2.1. 按大小特化的内存分配
编译器现在会为小对象调用按大小特化的分配例程。发布说明声称,对于小于 80 字节的分配可减少高达 30% 的开销,而对于分配密集型程序整体约减少 1%。
我不会不经测量就相信发布说明,因此:
 1type small struct{ a, b, c, d int }
 2
 3var sink any
 4
 5func BenchmarkAlloc(b *testing.B) {
 6	for b.Loop() {
 7		sink = &small{}
 8	}
 9}
10
11func BenchmarkSlice(b *testing.B) {
12	for b.Loop() {
13		sink = make([]byte, 48)
14	}
15}
1# 默认(启用按大小特化的 malloc)
2BenchmarkAlloc-12     3000000     5.358 ns/op
3BenchmarkSlice-12     3000000    13.58 ns/op
4
5# GOEXPERIMENT=nosizespecializedmalloc
6BenchmarkAlloc-12     3000000     8.722 ns/op
7BenchmarkSlice-12     3000000    20.81 ns/op
8
在 Apple Silicon 上,一个只做分配的微基准测试快了 30–35%。也就是说:这是最佳情况,是在实验室条件下、由一个专门为让数字好看而设计的基准测试取得的。在真实程序中,GC 和实际工作会掩盖掉大部分收益。约 1% 的说法才是诚实的那一个。
代价体现在二进制体积上。Hello World:
12413202 bytes  (默认)
22361826 bytes  (nosizespecializedmalloc)
大约固定增加 50KB,与你的程序无关。你可以通过 GOEXPERIMENT=nosizespecializedmalloc 退出该特性,但这个逃生口计划在 Go 1.28 中移除,因此请把它当作报告 bug 时的临时变通方案,而不是长期的生活方式。
2.2. Goroutine 泄漏分析现已真正可用
该特性在 Go 1.26 中处于实验阶段,在 1.27 中正式可用。goroutineleakprofile GOEXPERIMENT 已经移除,现在开箱即用。
 1func leak() {
 2	ch := make(chan int) // 永远不会有人发送。没有人。
 3	go func() {
 4		<-ch
 5	}()
 6}
 7
 8func main() {
 9	for range 3 {
10		leak()
11	}
12	runtime.GC()
13	runtime.GC()
14	pprof.Lookup("goroutineleak").WriteTo(os.Stdout, 1)
15}
1goroutineleak profile: total 3
23 @ 0x104de3f18 0x104d7f0b0 0x104d7ec34 0x104e374f4 0x104dea024
3#	0x104e374f3	main.leak.func1+0x23	/tmp/go127/leak/main.go:12
三个 goroutine 永久阻塞,并且附带了文件和行号,精确指向你写下这段代码的位置。
其背后的技巧确实十分巧妙:它复用了垃圾回收器的可达性分析。如果 goroutine G 阻塞在原语 P 上,并且 P 从任何可运行的 goroutine(或这些 goroutine 可能唤醒的任何对象)都不可达,那么就不可能再有任何东西触碰 P,因此 G 永远不会被唤醒。这不是启发式方法,而是一个证明。
同样的设计也免费带来了它的局限:如果通道或互斥锁可以通过全局变量访问,或者通过某个仍在运行的 goroutine 的局部变量访问,那么 GC 仍然能看到它,运行时就无法得出任何结论。请注意,即便是上面这个玩具示例,也需要调用两次 runtime.GC() 才能报告。它不会捕获所有情况。
不过,它确实能够捕获经典的"忘记取消 context,工作 goroutine 永远存活"这类问题,而这恰恰是大多数时候最常见的泄漏。
如果你导入了 net/http/pprof,它同时也位于 /debug/pprof/goroutineleak。把它接入 staging 环境,每周检查一次,并静静地感到惊恐。
这项工作由 Uber 的 Vlad Saioc 贡献,他值得一杯由自己挑选的饮品。
2.3. 调用栈现在会告诉你是哪个请求崩溃了
对于声明 Go 1.27 或更高版本的模块,调用栈的头部行现在会包含 runtime/pprof 的 goroutine 标签。
 1func handle(ctx context.Context) {
 2	var wg sync.WaitGroup
 3	wg.Go(func() {
 4		buf := make([]byte, 4<<10)
 5		os.Stdout.Write(buf[:runtime.Stack(buf, true)])
 6	})
 7	wg.Wait()
 8}
 9
10func main() {
11	labels := pprof.Labels("request", "GET /orders/42", "tenant", "acme")
12	pprof.Do(context.Background(), labels, handle)
13}
1goroutine 3 [running] {request: "GET /orders/42", tenant: acme}:
2main.handle.func1()
3	/tmp/go127/tblabel/main.go:15 +0x40
4sync.(*WaitGroup).Go.func1()
5	...
6goroutine 1 [sync.WaitGroup.Wait] {request: "GET /orders/42", tenant: acme}:
7...
重要的细节是:标签会被子 goroutine 继承。 Goroutine 3 从未设置过标签,它的标签是从父 goroutine 那里得来的。
因此,下次生产环境死锁、有人向进程发送 SIGQUIT 时,你看到的将不再是 4,000 个看起来完全相同的 goroutine,而是 4,000 个标注了其所属请求和租户的 goroutine。在你的请求入口处添加三行 pprof.Do,就能换来这一切。
由于标签中可能包含你不希望输出到 stderr 的内容,GODEBUG=tracebacklabels=0 可以关闭该功能,并且这一退出选项明确计划永久保留。
2.4. asynctimerchan 已永久移除
Go 1.23 将定时器通道改为无缓冲(同步)的,并提供了 asynctimerchan=1 以恢复旧行为。在 1.27 中,该设置被永久移除。time 包的通道现在完全是同步的,没有任何协商余地。
与此同时引入的策略同样值得关注。残留在你 go.mod 中已被移除的 GODEBUG 不会自动导致构建失败,只有当它被设置为旧值时才会失败:
1# go.mod 包含:godebug asynctimerchan=1
2go: error loading go.mod:
3go.mod:5: removed GODEBUG "asynctimerchan" set to old value "1" (https://go.dev/doc/godebug#go-127)
4
5# go.mod 包含:godebug asynctimerchan=0
6(构建正常)
这意味着,真正会受到提醒的,只有那些确实依赖已被移除行为的人。那些把它设置为最终默认值并且忘掉了的人,可以继续不去想这件事。这是一项考虑周到的 API 考古学成果。
3. 标准库
3.1. encoding/json/v2:引擎在飞行中被替换
这是最重大的变化。两年多的提案讨论终于落地。
现在有三个包,理解这种划分就完成了大半工作:
| 包 | 职责 |
|---|---|
encoding/json | 你所熟悉的 v1 API。行为 100% 未变。 现在构建于 v2 之上 |
encoding/json/v2 | 语义处理。Go 值 ↔ JSON |
encoding/json/jsontext | 语法处理。JSON 作为词法单元流 |
最重要的一点是,encoding/json 已经在一套完全不同的实现之上重建,并且行为完全一致。具体如下:
1// Go 1.27 的 encoding/json.Unmarshal,已节略
2func Unmarshal(data []byte, v any) error {
3	return jsonv2.Unmarshal(data, v, DefaultOptionsV1())
4}
所有遗留的 v1 怪癖都被编码为选项,打包进 DefaultOptionsV1(),而 v1 API 始终应用这一组选项。这意味着以下代码在 1.26 和 1.27 中的行为相同:
1var m map[string]int
2json.Unmarshal([]byte(`{"a":1,"a":2}`), &m)  // <nil>, map[a:2]
是的,v1 仍然会悄无声息地接受重复的键并取最后一个。它一直如此,至今仍然如此。兼容性意味着连不好的部分也一并兼容。
与此同时,v2 有自己的主张:
1var m map[string]int
2jsonv2.Unmarshal([]byte(`{"a":1,"a":2}`), &m)
3// jsontext: duplicate object member name "a"
4
5var s string
6jsonv2.Unmarshal([]byte("\"\xff\""), &s)
7// jsontext: invalid UTF-8 after offset 1
重复的键和无效的 UTF-8 都会被拒绝。两者都确实危险,而不仅仅是不整洁。当两个解析器对于哪个重复键生效产生分歧时,就会出现安全漏洞。CouchDB 的 CVE-2017-12635 正是这样一个案例:一个 JSON 请求体中包含两个 roles 键,验证器读取了其中一个,而存储层读取了另一个。拒绝才是正确的做法。
选项是可变参数的:
 1type Config struct {
 2	Name    string   `json:"name"`
 3	Tags    []string `json:"tags,omitzero"`
 4	Timeout int      `json:"timeout,omitzero"`
 5}
 6
 7out, _ := jsonv2.Marshal(Config{Name: "api"})
 8// {"name":"api"}
 9
10// 排序的 map 键 + 缩进
11out, _ = jsonv2.Marshal(map[string]int{"b": 2, "a": 1},
12	jsonv2.Deterministic(true), jsontext.WithIndent("  "))
13// {
14//   "a": 1,
15//   "b": 2
16// }
17
18// 拒绝未知字段——此前需要使用 Decoder 和 DisallowUnknownFields()
19var c Config
20err := jsonv2.Unmarshal([]byte(`{"name":"api","nope":1}`), &c,
21	jsonv2.RejectUnknownMembers(true))
22// json: cannot unmarshal JSON string into Go main.Config:
23//   unknown object member name "nope"
Deterministic、MatchCaseInsensitiveNames、StringifyNumbers、FormatNilSliceAsNull、OmitZeroStructFields——大多数此前需要借助第三方库或手写 MarshalJSON 才能解决的问题,现在都变成了标志位。
迁移方案也是最精彩的部分。后出现的选项优先生效,因此你可以逐项采用 v2 的严格性:
1// 保留 v1 语义,但像 v2 一样拒绝重复的键
2jsonv2.Unmarshal(data, &v,
3	json.DefaultOptionsV1(),
4	jsontext.AllowDuplicateNames(false))
5// duplicate object member name
你无需将一个 20 万行的代码库移植到 v2,就能停止接受重复的键。只需切换一个选项。对于规模较大的项目,这是切实可行的路径。
性能方面:编组大致持平,解组则明显更快。 如果出现问题,GOEXPERIMENT=nojsonv2 可以恢复旧的实现。而这一退出选项最终也将被移除,因此请提交 issue,而不是就此安于现状。
jsontext 是底层层次:Encoder/Decoder 以 Token 和 Value 的形式遍历 JSON,并通过状态机确保你的代码正确无误。当你在编写流式转换器或 JSON 过滤器,并且根本不想实例化 Go 值时,就应该使用它。
3.2. 标准 uuid 包
终于来了。RFC 9562 进入了标准库,无需 go get。
 1import "uuid"
 2
 3func main() {
 4	fmt.Println(uuid.NewV4())
 5	// b97aa695-da08-472c-af81-ff088129019f
 6
 7	// v7:高 48 位是时间戳,因此这些值总是按创建顺序排序
 8	a, b := uuid.NewV7(), uuid.NewV7()
 9	fmt.Println(a.Compare(b) < 0) // true
10
11	u, err := uuid.Parse("urn:uuid:0198a1b2-c3d4-7e5f-8a9b-0c1d2e3f4a5b")
12	fmt.Println(u, err)
13	// 0198a1b2-c3d4-7e5f-8a9b-0c1d2e3f4a5b <nil>
14
15	fmt.Println(uuid.Nil(), uuid.Max())
16	// 00000000-0000-0000-0000-000000000000 ffffffff-ffff-ffff-ffff-ffffffffffff
17}
整个 API 由 New、NewV4、NewV7、Nil、Max、Parse、MustParse 以及一个类型 type UUID [16]byte 组成。就是这些。你甚至可以在咖啡变凉之前读完整个包的文档。
值得了解的细节:
UUID是[16]byte,因此==可以直接使用,并且可以直接用作 map 的键。设计与google/uuid相同。Nil和Max是函数,而不是变量。 因为包级的var Nil UUID就像一把指向你脚的上了膛的枪,总会有人在某处对它赋值。- 随机位来自密码学安全的生成器。
- 它实现了
encoding.TextMarshaler/TextUnmarshaler/TextAppender,因此可以直接用于 JSON 结构体。 - 数据库主键应首选
NewV7。 按时间排序意味着你的 B 树索引不再碎片化,而这正是 v4 UUID 众所周知的弱点。
你现在可以删除一个依赖了。如果你需要 v1/v3/v5 或更复杂的解析选项,第三方库仍然有其用武之地。
3.3. crypto/mldsa:后量子签名,而且体积巨大
Go 1.24 提供了 crypto/mlkem 用于后量子密钥交换。Go 1.27 带来了另一半:ML-DSA 签名,即标准化为 FIPS 204 的方案。
 1sk, _ := mldsa.GenerateKey(mldsa.MLDSA65())
 2pk := sk.PublicKey()
 3
 4msg := []byte("release the gophers")
 5opts := &mldsa.Options{Context: "gosuda.org/blog"}
 6
 7sig, _ := sk.Sign(rand.Reader, msg, opts)
 8
 9fmt.Println("private key seed:", len(sk.Bytes()), "bytes")  // 32
10fmt.Println("public key:", len(pk.Bytes()), "bytes")        // 1952
11fmt.Println("signature:", len(sig), "bytes")                // 3309
12
13fmt.Println(mldsa.Verify(pk, msg, sig, opts))
14// <nil>
15fmt.Println(mldsa.Verify(pk, msg, sig, &mldsa.Options{Context: "other"}))
16// mldsa: invalid signature
看看这些数字。单个签名为 3,309 字节。 Ed25519 只有 64 字节。这是 50 倍的增长,而公钥又在此基础上接近 2KB。如果在证书链中塞入几个这样的数据,你的 TLS 握手就需要专门的 MTU 策略了。
这就是当今量子抗性的真实代价,也是为什么没有人会在明天就把所有东西都切换过去。但它现在已经位于标准库之中,这正是你希望它在你需要之前所处的位置。
Options.Context 用于域分离:对于不同的用途,使用同一把密钥签名,但为每种用途指定不同的 context,那么来自一个 context 的签名在另一个 context 中将无法通过验证。上面的示例正好展示了这一点:相同的密钥、相同的消息、不同的 context,结果被拒绝。
PrivateKey 实现了 crypto.Signer,因此可以无缝接入现有接口。crypto/x509 支持 ML-DSA 密钥和签名,crypto/tls 则在 TLS 1.3 中支持 MLDSA44/MLDSA65/MLDSA87 签名方案。
此外还有 SignDeterministic,它跳过了随机数部分,便于测试和可复现构建。
3.4. simd:无需汇编的向量指令
Go 1.26 以实验形式引入了与架构相关的 simd/archsimd。Go 1.27 新增了 simd,它可移植且与向量宽度无关。通过 GOEXPERIMENT=simd 启用。
 1// dst = a*x + y
 2func axpy(dst, x, y []float32, a float32) {
 3	va := simd.BroadcastFloat32s(a)
 4	w := va.Len()
 5
 6	i := 0
 7	for ; i+w <= len(x); i += w {
 8		vx := simd.LoadFloat32s(x[i:])
 9		vy := simd.LoadFloat32s(y[i:])
10		vx.MulAdd(va, vy).Store(dst[i:])
11	}
12	// 使用部分加载/存储处理尾部——无需标量清理循环
13	if i < len(x) {
14		vx, _ := simd.LoadFloat32sPart(x[i:])
15		vy, _ := simd.LoadFloat32sPart(y[i:])
16		vx.MulAdd(va, vy).StorePart(dst[i:])
17	}
18}
1$ GOEXPERIMENT=simd go1.27rc3 run ./simddemo
2vector bits: 128 emulated: false
3[4 7 10 13 16 19 22 25 28 31]
关键的设计选择是:向量宽度从不被硬编码。 你在运行时通过 va.Len() 获取它。VectorBitSize() 告诉你实际宽度,Emulated() 则告诉你得到的是真正的硬件,还是一种礼貌的软件模拟。我的 Mac 报告的是 128 位 NEON;AVX-512 机器会报告更大的宽度;而没有任何向量支持的机器会报告模拟模式,代码依然能够运行。
LoadFloat32sPart/StorePart 值得特别一提。手写 SIMD 最烦人的部分始终是数组末尾参差不齐的尾部,而它无需单独的标量循环就能处理这一问题。
它仍处于实验阶段,API 尚不稳定,请勿用于生产环境。但这确实是 Go 代码而非汇编或 cgo,这一点本身就是一件非常重大的事。
3.5. hash/maphash.Hasher
这是一个新的接口,用于描述值类型与基于哈希的容器之间的契约:
1type Hasher[T any] interface {
2	Hash(*Hash, T)
3	Equal(x, y T) bool
4}
为什么需要它?因为 Go 的内置 map 只接受 comparable 的键。你不能以 slice 作为键。你也无法定义"忽略大小写的相等"。Hasher 可以同时解决这两个问题:
 1type CaseInsensitive struct{}
 2
 3func (CaseInsensitive) Hash(h *maphash.Hash, s string) {
 4	h.WriteString(strings.ToLower(s))
 5}
 6func (CaseInsensitive) Equal(x, y string) bool {
 7	return strings.ToLower(x) == strings.ToLower(y)
 8}
 9
10var seed = maphash.MakeSeed()
11
12func hashOf[T any](hr maphash.Hasher[T], v T) uint64 {
13	var h maphash.Hash
14	h.SetSeed(seed)   // 使用相同的种子,否则这一切都没有意义
15	hr.Hash(&h, v)
16	return h.Sum64()
17}
18
19fmt.Println(hashOf(CaseInsensitive{}, "Go") == hashOf(CaseInsensitive{}, "GO"))
20// true
对于普通的 == 语义,可以使用 ComparableHasher[T]:
1hashOf(maphash.ComparableHasher[int]{}, 42)
需要注意的是:Hasher 是一个接口,而不是数据结构。 目前尚没有标准的哈希表或布隆过滤器来消费它。这是为未来容器包打下的基础。目前,你可以在构建自己的数据结构时使用它,或者使用现有的实现,例如 go/types.Hasher(它允许你将 types.Type 用作 map 的键,并遵循 Identical 语义)。
种子的管理由你自己负责。如果上面的 hashOf 每次调用都生成一个新的种子,那么相同的值会得到不同的哈希,示例将输出 false,这正是我第一次尝试时写出的错误。每个容器使用一个种子。(种子是随机化的,用于防御哈希洪水式的拒绝服务攻击,这就是它不只是一个常量的原因。)
3.6. httptest.NewTestServer + synctest.Sleep:Sleeper 的胜利
如果你只从本次发布中采纳一项内容,那就选这一项。
testing/synctest 在 Go 1.25 中毕业,为并发代码的测试提供了虚拟时钟。然而,一旦测试触及真实的网络,这种假象便会瓦解。Go 1.27 的 httptest.NewTestServer 使用了内存中的虚拟网络,因此这一"气泡"得以保持完整。而 synctest.Sleep(等价于 time.Sleep + synctest.Wait)则让这套机制更加完备。
下面是一个带指数退避重试的测试:
 1func TestRetryWithBackoff(t *testing.T) {
 2	synctest.Test(t, func(t *testing.T) {
 3		var hits int
 4		srv := httptest.NewTestServer(t, http.HandlerFunc(
 5			func(w http.ResponseWriter, r *http.Request) {
 6				hits++
 7				if hits < 3 {
 8					w.WriteHeader(http.StatusServiceUnavailable)
 9					return
10				}
11				io.WriteString(w, "ok")
12			}))
13
14		client := srv.Client()
15		start := time.Now()
16		var body string
17		for attempt := range 5 {
18			resp, err := client.Get(srv.URL)
19			if err != nil {
20				t.Fatal(err)
21			}
22			b, _ := io.ReadAll(resp.Body)
23			resp.Body.Close()
24			if resp.StatusCode == http.StatusOK {
25				body = string(b)
26				break
27			}
28			synctest.Sleep(time.Duration(1<<attempt) * time.Second)
29		}
30
31		if body != "ok" {
32			t.Fatalf("got %q", body)
33		}
34		// 退避时间应恰好为 1s + 2s = 3s
35		if elapsed := time.Since(start); elapsed != 3*time.Second {
36			t.Fatalf("elapsed = %v, want 3s", elapsed)
37		}
38		t.Logf("hits=%d elapsed=%v", hits, time.Since(start))
39	})
40}
1=== RUN   TestRetryWithBackoff
2    x_test.go:48: hits=3 elapsed=3s
3--- PASS: TestRetryWithBackoff (0.00s)
请读两遍。它针对一个真实的 HTTP 服务器模拟了三秒的退避,却在0.00 秒内完成。而断言是 elapsed == 3*time.Second,也就是_恰好_三秒,而不是"至少三秒,考虑调度抖动的话"。虚拟时钟不会抖动。
synctest.Sleep 的存在有其特定原因:如果你的测试与被测代码休眠相同的时长,那么究竟哪一个先醒来就只能靠猜。synctest.Sleep 会先睡眠,_然后_等待,直到气泡中的所有其他 goroutine 都处于持久阻塞状态,这样你观察到的就是系统已经稳定之后的状态。
超时、重试、断路器、限流器,你拥有的每一个依赖时间的 HTTP 客户端测试都可以变得快速且确定。如果你的测试套件目前是靠 time.Sleep(100 * time.Millisecond) 加上侥幸心理维持的,那么这就是你的出路。
3.7. 真正影响生产环境的 net/http 变化
这些变化悄无声息,但会在你的监控指标中体现出来。
HTTP/1 响应体在 Close 时自动排空。 未读取的内容现在会在关闭 body 时被排空(有一个保守的上限),从而使连接可以被复用。这意味着你终于可以删除那段自 2016 年起大家从同一个 Stack Overflow 回答中反复复制粘贴的咒语了:
1// 已不再需要
2defer func() {
3	io.Copy(io.Discard, resp.Body)
4	resp.Body.Close()
5}()
对于大多数程序而言,这要么没有影响,要么带来小幅改善。如果它让情况_变得更糟_,那么你很可能属于发布说明委婉描述的那一类情形:将 Transport.MaxIdleConns 设为 0,或者每个请求都新建一个 Client,从而完全绕过了空闲连接数限制。Transport.DisableKeepAlives = true 可以掩盖这一问题,但发布说明的真正建议是"更深入的排查可能会有所助益",这在 Go 团队的措辞里就是_你还有更大的麻烦_。
HTTP/2 客户端优先级(RFC 9218)。 服务器现在会遵循客户端的优先级信号。如果你更喜欢旧的轮询调度方式,可以设置 Server.DisableClientPriority = true。
Server.MaxHeaderValueCount。 限制服务器接受的请求头值的数量,默认值为 DefaultMaxHeaderValueCount。又一扇关上的门,防止有人"发送一万个请求头,然后看看会发生什么"。
用户提供的连接上的 ALPN。 如果你的 net.Conn 实现了 ConnectionState() tls.ConnectionState,那么 Transport 和 Server 将对其执行 TLS ALPN 协商。因此,通过代理的自定义拨号器仍然可以协商 HTTP/2。
3.8. 令人愉悦的小改进
strings.CutLast / bytes.CutLast。 Cut 在_第一个_分隔符处切分。此前没有"最后一个"的变体,因此大家都手写 LastIndex 加切片,而其中大约 30% 的人第一次尝试时都会出现差一错误。
1name, ext, ok := strings.CutLast("archive.tar.gz", ".")
2// archive.tar gz true
非常适合用于文件扩展名,以及解析 host:port,因为在后者中你必须找到_最后一个_冒号,毕竟 IPv6 地址中充满了冒号。
math/big.Int.Divide。 带有显式舍入模式的除法,取代了"我要的是 Quo 还是 Div?"这种碰运气式的选择:
1x, y := big.NewInt(-7), big.NewInt(2)
2
3new(big.Int).Divide(x, y, new(big.Int), big.Trunc)  // q=-3 r=-1
4new(big.Int).Divide(x, y, new(big.Int), big.Floor)  // q=-4 r=1
5new(big.Int).Divide(x, y, new(big.Int), big.Round)  // q=-4 r=1
6new(big.Int).Divide(x, y, new(big.Int), big.Ceil)   // q=-3 r=-1
如果你所在的领域中,舍入规则被写进了法规,那么这个功能正是为你准备的。
url.URL.Clone 和 url.Values.Clone。 深拷贝。旧的 *u 浅拷贝会共享 Userinfo 指针,从而产生那种需要一天才能找到、五秒钟就能修复的错误。
1orig, _ := url.Parse("https://gosuda.org/blog?tag=go&tag=1.27")
2clone := orig.Clone()
3clone.Host = "example.com"
4fmt.Println(orig.Host, clone.Host)  // gosuda.org example.com
net.UnixConn 的读取方法现在直接返回 io.EOF,而不再将其包装在 net.OpError 中。err == io.EOF 现在可以正常工作了,它本应一直如此。
database/sql.ConvertAssign 和 driver.RowsColumnScanner。 面向驱动开发者的功能。前者公开了 Rows.Scan 所执行的类型转换;后者允许驱动直接扫描到用户的目标变量中,省去了中间的一次分配。
unicode 从 15 升级到 17。 一次跨越两个版本。字符串分类和规范化的行为可能会发生细微变化。如果你的测试依赖于此,你会发现问题的。
compress/flate 变快了,但其输出字节可能与 Go 1.26 不同。 这一变化会级联影响 archive/zip、compress/gzip、compress/zlib 和 image/png。如果你的 golden 文件测试会对压缩输出进行哈希,那么它们将会失败,而且这并非回归。请在升级_之前_检查这一点,而不是在事故复盘时才发现。
4. 工具链
4.1. go fix 新增了更多现代化工具
go fix 正在悄然转变为一个代码现代化工具。Go 1.27 新增了 atomictypes、embedlit、slicesbackward 和 unsafefuncs。使用 -diff 可以预览:
 1package fixdemo
 2
 3import (
 4	"sync"
 5	"sync/atomic"
 6)
 7
 8type Base struct{ ID int }
 9type User struct {
10	Base
11	Name string
12}
13
14func New() User {
15	return User{Base: Base{ID: 1}, Name: "gopher"}
16}
17
18var counter int64
19
20func Incr() { atomic.AddInt64(&counter, 1) }
21
22func Reverse(s []string) {
23	for i := len(s) - 1; i >= 0; i-- {
24		_ = s[i]
25	}
26}
27
28func Spawn(wg *sync.WaitGroup) {
29	wg.Add(1)
30	go func() {
31		defer wg.Done()
32	}()
33}
1$ go1.27rc3 fix -diff ./fixdemo
 1 import (
 2+	"slices"
 3 	"sync"
 4 	"sync/atomic"
 5 )
 6
 7 func New() User {
 8-	return User{Base: Base{ID: 1}, Name: "gopher"}
 9+	return User{ID: 1, Name: "gopher"}
10 }
11
12-var counter int64
13+var counter atomic.Int64
14
15-func Incr() { atomic.AddInt64(&counter, 1) }
16+func Incr() { counter.Add(1) }
17
18 func Reverse(s []string) {
19-	for i := len(s) - 1; i >= 0; i-- {
20-		_ = s[i]
21+	for _, v := range slices.Backward(s) {
22+		_ = v
23 	}
24 }
25
26 func Spawn(wg *sync.WaitGroup) {
27-	wg.Add(1)
28-	go func() {
29-		defer wg.Done()
30-	}()
31+	wg.Go(func() {
32+	})
33 }
在一个很小的文件上,有四个现代化工具被触发:
embedlit:使用 §1.2 中的新语法改写嵌入字面量atomictypes:atomic.AddInt64(&x, 1)变为atomic.Int64.Add(1),这使得非原子访问成为不可能,并悄然修复了你未曾察觉的 32 位对齐错误slicesbackward:反向循环变为slices.Backwardwaitgroupgo:Add/go/Done的固定套路变为wg.Go(从 1.26 中的waitgroup更名,以避免歧义)
go tool fix help 列出全部 26 个工具;go tool fix help <name> 则解释某一个工具。另外,fmtappendf 因"风格上的考虑"被移除,这是一种措辞极其圆润的说法,用来描述那个 issue 讨论串中发生的事情。
在一个旧代码库上运行 go fix ./... 是一个非常令人满足的下午。当然,请先阅读 diff。
4.2. go test 默认运行 stdversion
这是最有可能打断你工作的改动。
go test 现在默认运行 stdversion vet 检查,会标记出那些比你 go.mod 中 go 指令所允许的版本更新的标准库符号:
1// go.mod 中写的是:go 1.24
2package sv
3
4import "strings"
5
6func Ext(name string) string {
7	_, ext, _ := strings.CutLast(name, ".")  // CutLast 是 1.27 的符号
8	return ext
9}
1$ go1.27rc3 test ./...
2# sv
3./x.go:6:23: strings.CutLast requires go1.27 or later (module is go1.24)
4FAIL	sv [build failed]
这消除了一种经典的失败模式:一切在你的机器上(使用最新工具链)运行良好,却在 CI 或用户较旧的环境中爆炸。如果你发布的库使用了保守的 go 指令,这将是一份礼物。
4.3. go test -json 新增 OutputType
"Action":"output" 行现在可以携带一个可选的 "OutputType" 字段:"error"、"error-continue" 或 "frame"。
1'frame'  '=== RUN   TestFail\n'
2None     '    x_test.go:6: hello\n'
3'error'  '    x_test.go:7: boom\n'
4'frame'  '--- FAIL: TestFail (0.00s)\n'
5'frame'  'FAIL\n'
t.Log 的输出(无该字段)、t.Error 的输出(error)以及框架生成的行(frame)现在可以相互区分。任何曾经编写过正则表达式来判断测试输出中哪些行是"真正内容"的人,现在都可以把它删掉了。
4.4. go doc 改进
package@version 语法。 无需将某个包添加到你的模块中,即可阅读其特定版本的文档:
1$ go1.27rc3 doc golang.org/x/sync/errgroup@v0.10.0
2package errgroup // import "golang.org/x/sync/errgroup"
3...
在升级之前查看有哪些变化时非常方便。
-ex 与示例源码打印:
 1$ go1.27rc3 doc -ex strings | grep Example
 2    func ExampleClone()
 3    func ExampleCompare()
 4    func ExampleContains()
 5    func ExampleCut()
 6    func ExampleCutPrefix()
 7    ...
 8
 9$ go1.27rc3 doc strings.ExampleCut
10package main
11
12import (
13	"fmt"
14	"strings"
15)
16
17func main() {
18	show := func(s, sep string) {
19		before, after, found := strings.Cut(s, sep)
20		fmt.Printf("Cut(%q, %q) = %q, %q, %v\n", s, sep, before, after, found)
21	}
22	show("Gopher", "Go")
23	...
24}
25
26Output:
27Cut("Gopher", "Go") = "", "pher", true
示例源码_以及_预期输出都直接显示在终端中,无需打开一个下周四仍会开着的浏览器标签页。
4.5. go mod tidy 清理你的 require 块
对于 go 1.27 或更高版本的模块,go mod tidy 会将分散的 require 块合并为最多两个(直接依赖和间接依赖),并保留附带的注释。
 1// 之前
 2module tidydemo
 3
 4go 1.27
 5
 6require golang.org/x/sync v0.10.0
 7
 8// networking
 9require golang.org/x/net v0.33.0
10
11require (
12	golang.org/x/sys v0.28.0 // indirect
13)
14
15require golang.org/x/text v0.21.0 // indirect
 1// 之后:go mod tidy
 2module tidydemo
 3
 4go 1.27
 5
 6require (
 7	// networking
 8	golang.org/x/net v0.33.0
 9	golang.org/x/sync v0.10.0
10)
请注意,// networking 注释被保留了下来。这主要是在善后 Git 合并冲突的解决,而零散的 require 块正是在那里诞生的。如果你的团队中有超过三个人在添加依赖,那么你的 go.mod 冲突将会明显减少。
4.6. 杂项
- 移除
bzr支持。 如果这影响到你,我真的很想听听你的故事。 - 仅提供端口时,
go tool trace -http绑定到 localhost。-http=:6060不再监听所有网络接口。如果你确实需要,请使用-http=0.0.0.0:6060。这一行为现在与go tool pprof保持一致,并防止偶发的意外公开性能分析器。 - 响应文件(
@file) 现在被compile、link、asm、cgo、cover和pack支持,采用与 GCC 兼容的格式。适用于那些超出命令行长度限制的构建系统,比如 Bazel。
5. 编译器、链接器、移植
编译器。 //line 指令中的相对文件名现在会相对于所在文件的目录进行解析,与 go/scanner 保持一致。如果你编写代码生成器,这一点很重要。
函数字面量(闭包)的符号名也变得更简单了:无论是否内联,名称都相同,并且同一字面量的多个实例可能在二进制文件中共享代码。功能上没有变化,但有一个例外:通过 reflect.Value.Pointer 比较函数身份的代码,将比以前更频繁地看到"相等"。这种比较从来都不合法,但如果你的代码中有这样的比较,那么现在它将开始更大声地向你撒谎。
链接器。 新增的 -macos 和 -macsdk 选项用于设置 macOS LC_BUILD_VERSION 加载命令中的操作系统和 SDK 版本。
移植。
- Darwin 现在要求 macOS 13 Ventura 或更高版本,这在 1.26 中已经宣布。请检查你的 CI 运行器。
- PowerPC(
GOOS=linux GOARCH=ppc64)切换到 ELFv2 ABI。 需要 Linux 内核 3.13+(RHEL7 将其回移植到了 3.10)。现在支持 Cgo、PIE 和外部链接。如果你使用 cgo,但需要静态的纯 Go 二进制文件,请设置CGO_ENABLED=0。
6. 升级检查清单
Go 1.27 高度重视兼容性,但在升级版本之前,请检查以下内容:
- 针对压缩输出的 golden 文件测试。
compress/flate更换了编码器;gzip/zip/png 的字节可能会不同。 - 匹配 JSON 错误信息字符串的测试。 行为一致;但错误文本并不一致。
-
go.mod中已移除的 GODEBUG。asynctimerchan、gotypesalias、tlsrsakex、tls3des、tls10server、tlsunsafeekm、x509keypairleaf,这些只有在被设置为其_旧_值时才会导致构建失败。 -
stdversion违规。go test现在会检测这些问题。如果你维护的库使用了保守的go指令,请尽早运行它。 - macOS 12 或更早版本的 CI 运行器。 已不再受支持。
- 对函数字面量符号名称进行断言的测试,以及对
reflect.Value.Pointer函数比较的测试。 -
Transport.MaxIdleConns = 0或每个请求新建一个Client。结合自动排空响应体的机制,这可能会导致变慢。
结束语
Go 1.27 是一个许多推迟的维护工作同时到期的版本。
泛型方法是 1.18 泛型工作中缺失的一块拼图。结构体字面量字段选择器解决了一个存在了十一年的 issue。encoding/json/v2 经历了两年的提案讨论。而 uuid 填补了一个几乎所有 Go 项目十年来都在用同一个第三方依赖打补丁的空白。
如果你想按优先级真正从中获益,建议顺序如下:
httptest.NewTestServer+synctest.Sleep:依赖时间的 HTTP 测试变得快速且确定。这是整个版本中投入产出比最高的功能。- Goroutine 泄漏分析:在 staging 中暴露一个端点,并做好被打击谦卑的准备。
- 调用栈 goroutine 标签:在请求入口处添加三行
pprof.Do,就能让你下一次凌晨 3 点的栈转储变得可读。 go fix ./...:让工具来完成现代化改造。encoding/json/v2:不必着急,逐个选项采用即可。
获取 go1.27rc3,现在就用它运行你的测试套件。清单上的每一项,在周二下午发现,都要比在事故期间发现愉快得多。
参考资料