 GoSuda
Randflake ID:基于 Sparx64 分组密码的分布式 64 位唯一 ID 生成

考虑这样一种情形:我们需要生成唯一的64位随机数,并且外部各方不应能够预测下一个或上一个数字。
在此,我们可以生成一个8字节的随机值,检查其是否已存在于数据库中,若唯一则将其存储。
然而,这种方法存在若干缺点。我们必须将生成的每个数字存储在数据库中以确保唯一性。至少一次数据库往返的要求会造成延迟问题,尤其是在可扩展性至关重要的分布式环境中。
为了解决这些问题,我们推出了Randflake ID:一种分布式、均匀、不可预测、唯一的随机ID生成器。
Randflake ID如何工作?
Randflake ID受到Snowflake ID的启发,后者是X(原Twitter)开发的、被广泛使用的k-sorted ID生成机制。
Snowflake ID使用当前时间戳、节点ID和本地计数器来生成标识符。
我们进一步扩展了这一方法,用于随机唯一ID的生成,并新增了一个密钥元素。
关键思想是在现有的唯一ID生成器之上添加一个分组密码层,从而实现对数字之间关系的不可预测性。
分组密码是一种基本的密码学函数,它将固定长度的明文分组转换为相同长度的密文分组。这种变换由密码密钥控制。分组密码的显著特征在于其可逆性:它必须是一一映射(双射)函数,确保每个唯一输入对应一个唯一输出,反之亦然。这一性质对于解密至关重要,在应用正确密钥时,可以从密文中恢复原始明文。
通过将分组密码作为一一映射函数使用,我们可以保证每个唯一输入在限定范围内都会产生一个对应的唯一输出。
结构与设计考量
基于这些基本概念,让我们考察Randflake ID如何在实践中实现这些思想。
Randflake ID的结构包括一个精确到秒的30位Unix时间戳、一个17位节点标识符、一个17位本地计数器,以及一个基于sparx64算法的64位分组密码。
以下是一些设计决策:
Google Cloud Platform中的某些VM实例可以将时钟同步到0.2毫秒的精度,但这种精度在公共互联网或其他云服务提供商处并不可用。
我们选择秒级精度,因为我们只能在几毫秒的分辨率内有效地在节点之间同步时钟。
17位节点标识符允许同一时刻存在131072个独立生成器,可以按进程、按核心或按线程的方式进行分配。
在高吞吐量系统中,17位本地计数器可能不足。为了匹配吞吐量,我们可以分配多个生成器,每个生成器具有不同的节点ID,使其在同一进程或线程中工作。
我们采用sparx64作为64位分组密码,这是一种现代的轻量级ARX型分组密码。
Randflake ID提供内部可追溯性,只有拥有密钥的人才能揭示其来源节点ID和时间戳。
理论最大吞吐量为17,179,869,184 ID/秒,这对于大多数全球规模的应用已经足够。
Randflake ID生成的伪代码
为了进一步说明Randflake ID的生成过程,以下Python伪代码提供了一个简化的实现:
 1import time
 2import struct
 3from .sparx64 import Sparx64
 4
 5# 常量
 6RANDFLAKE_EPOCH_OFFSET = 1730000000  # 2024年10月27日星期日 UTC时间 3:33:20 AM
 7
 8# 位分配
 9RANDFLAKE_TIMESTAMP_BITS = 30  # 时间戳占30位(寿命为34年)
10RANDFLAKE_NODE_BITS = 17  # 节点ID占17位(最多131072个节点)
11RANDFLAKE_SEQUENCE_BITS = 17  # 序列号占17位(最多131072个序列)
12
13# 派生常量
14RANDFLAKE_MAX_TIMESTAMP = RANDFLAKE_EPOCH_OFFSET + (1 << RANDFLAKE_TIMESTAMP_BITS) - 1
15RANDFLAKE_MAX_NODE = (1 << RANDFLAKE_NODE_BITS) - 1
16RANDFLAKE_MAX_SEQUENCE = (1 << RANDFLAKE_SEQUENCE_BITS) - 1
17
18class Randflake:
19    def __init__(self, node_id: int, secret: bytes):
20        self.node_id = int(node_id)
21        self.sequence = int(0)
22        self.rollover = int(time.time())
23        self.sbox = Sparx64(secret)
24
25    def _new_raw(self) -> int:
26        while True:
27            now = int(time.time())
28
29            self.sequence += 1
30            sequence = self.sequence
31
32            if sequence > RANDFLAKE_MAX_SEQUENCE:
33                if now > self.rollover:
34                    self.sequence = 0
35                    self.rollover = now
36                    sequence = 0
37                else:
38                    continue
39
40            timestamp = now - RANDFLAKE_EPOCH_OFFSET
41            return (timestamp << 34) | (self.node_id << 17) | sequence
42
43    def generate(self) -> int:
44        id_raw = self._new_raw()
45        src = struct.pack("<q", id_raw)
46        dst = bytearray(8)
47        self.sbox.encrypt(dst, src)
48        return struct.unpack("<q", dst)[0]
一个具有节点ID租约机制的生产就绪版Randflake实现可在GitHub上获取。
其他考量
在本节中,我们将讨论实现Randflake ID的一些其他考量。
节点ID协调
我们建议采用基于租约的节点ID协调方式。
在这种方式中,一个中央协调服务为每个生成器分配一个唯一的节点ID。
在租约期间,该节点ID不会被重新分配以确保唯一性,从而减少与协调服务的频繁通信。
持有租约的生成器可以在满足续期条件时向协调服务请求续租。
续期条件指的是租约续期必须满足的一组标准,例如生成器仍然处于活动状态且仍需要该节点ID。
租约持有者是当前节点ID范围的持有者。
若租约仍处于其有效时间段内,则该租约被视为有效且未过期。
通过这种方式,我们可以将每个租约续期周期的往返次数减少到一次,从而最大限度地降低延迟并提高分布式系统的效率。
针对时钟故障的缓解措施
租约服务在分配租约时必须检查时间戳的一致性。所分配的租约起始时间必须大于或等于上一次租约的起始时间。
如果当前时间戳小于租约起始时间或大于租约结束时间,生成器应拒绝该请求。
当时钟向后跳变时,此过程对于保护生成ID的唯一性至关重要。例如,若时钟向后跳变,则可能分配一个起始时间早于先前已分配租约的新租约,从而可能导致生成重复ID。通过拒绝时间戳位于现有租约期间内的请求,我们可以防止这种情况发生并维持ID的唯一性。
ID分布的均匀性
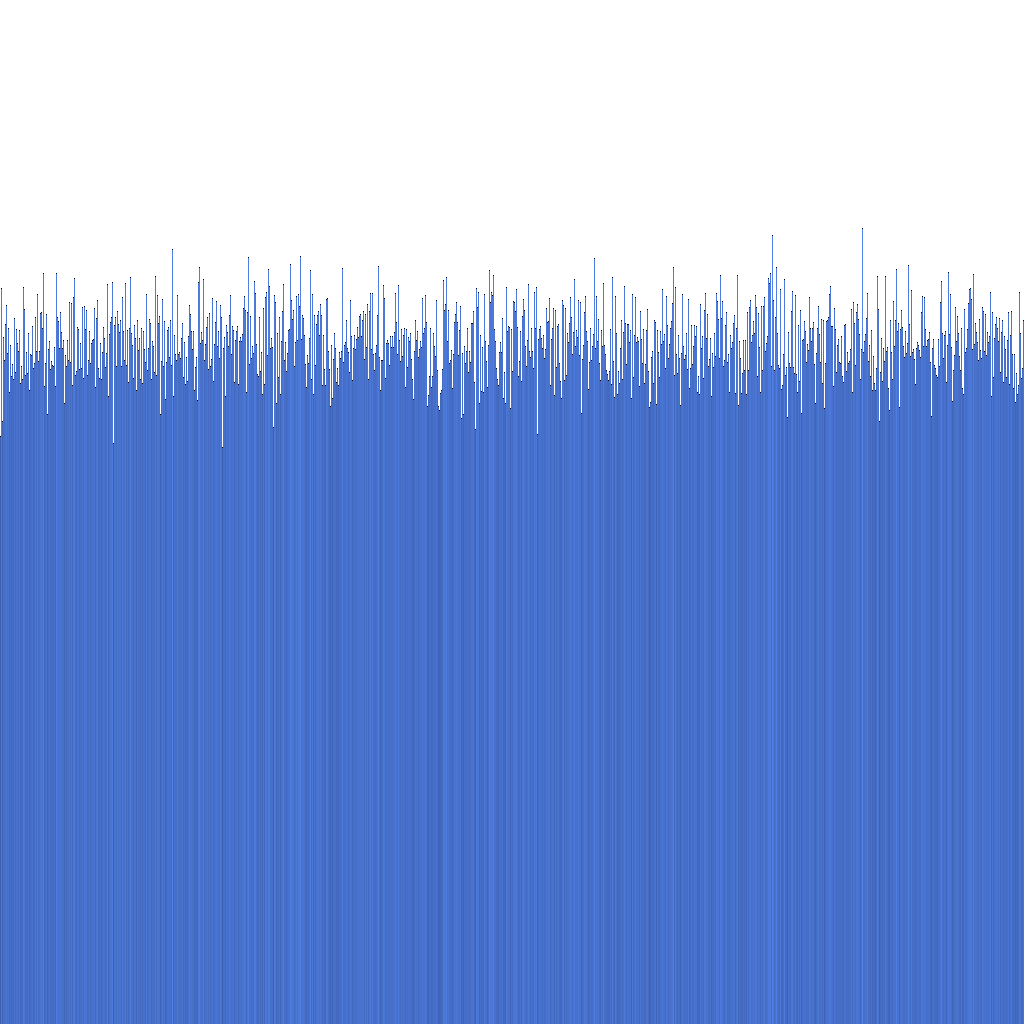
根据上方的直方图,我们可以看到生成的Randflake ID分布非常均匀。这表明ID分布可以直接用作分片键。
结论
在本文中,我们介绍了Randflake,这是一种结合了Snowflake和Sparx64优点的新型ID生成算法。
我们希望本文能为您提供对Randflake及其实现的全面理解。
您可以在GitHub上找到Randflake的完整源代码。
如果您有任何问题或建议,请不要犹豫与我们联系。我们也在寻求贡献者,以帮助改进Randflake并将其应用于其他编程语言。
我们计划发布一个面向Randflake和Snowflake的生产就绪协调服务,该服务将在GitHub上开源。敬请关注后续更新!